베테랑의 감을 AI에 넘기는 법 — 가중치를 드러내고 숙련자를 검수자로 세우기 (2)
감을 조건으로 쪼갰다면 이제 그 조건을 어떻게 합칠지, 감을 믿어도 되는 영역은 어디까지인지, 숙련자를 어떤 자리에 둘지를 정해야 합니다. 그로브 등의 임상 대 공식 예측 메타분석, 카너먼과 클라인의 직관 조건 논문, 정부 제조 암묵지 사업의 숙련자 보상 논란, WHO 수술 안전 체크리스트 연구를 바탕으로 기준을 완성하는 원칙과 여덟 단계 실행 순서를 정리했습니다.
조건을 쪼개는 일은 시작입니다. 어떻게 합칠지는 회사가 정해야 합니다. 그리고 그 기준의 마지막 검수자는 여전히 베테랑이어야 합니다.
1편에서는 숙련자의 감을 이름 붙은 조건 몇 개로 쪼개고, 조건마다 무엇으로 잴지 적는 법을 다뤘습니다.
쪼갠 다음에 남는 세 가지 질문
조건과 측정 방법이 정해지면 프로젝트는 대개 이렇게 흘러갑니다. 데이터를 모으고, 모델을 학습시키고, 정확도를 보고합니다. 그런데 이 흐름에서 자주 빠지는 질문이 세 가지 있습니다.
- 조건들을 어떤 비중으로 합칠 것인가.
- 숙련자의 감을 어디까지 정답으로 믿을 것인가.
- 숙련자는 이 과정에서 어떤 자리에 있는가.
세 질문 모두 기술보다 판단에 가깝습니다. 그래서 경영진이 직접 답해야 합니다.
원칙 하나. 가중치는 숨기지 말고 드러내십시오
조건을 합치는 단계에서 많은 프로젝트가 "AI가 알아서 학습하게 하자"로 넘어갑니다. 학습으로 비중을 찾는 것 자체는 괜찮습니다. 문제는 그 결과가 모델 안에 숨어 아무도 보지 못하는 경우입니다.
가중치는 기술이 아니라 판단입니다. 품질과 납기 중 무엇을 더 중요하게 볼지, 안전 여유를 얼마나 둘지는 회사가 정할 일입니다. 조건별 비중을 표나 화면에 꺼내 두고 숙련자와 관리자가 "이 조건이 이렇게 크게 잡혀도 됩니까"라고 따져 물을 수 있게 하십시오. 드러나 있으면 실수도 빨리 잡힙니다. 새로 넣은 조건의 비중이 0으로 들어가 있는 식의 실수는 생각보다 흔하고, 숨어 있으면 몇 달씩 아무도 모릅니다.
기준을 공식으로 만들어 두는 일 자체에도 근거가 있습니다. 의학·금융·범죄학 분야 136편의 연구를 묶은 그로브 등의 2000년 메타분석은 같은 정보를 사람이 머릿속에서 종합할 때보다 정해진 공식으로 종합할 때 평균 10% 정도 정확했다고 보고했습니다. 이 차이는 판단자의 경력과 관계없이 일관되게 나타났습니다. 숙련자가 틀려서가 아니라, 같은 사람도 날마다 조금씩 다르게 판단하기 때문입니다.
원칙 둘. 감을 믿어도 되는 영역과 아닌 영역을 가르십시오
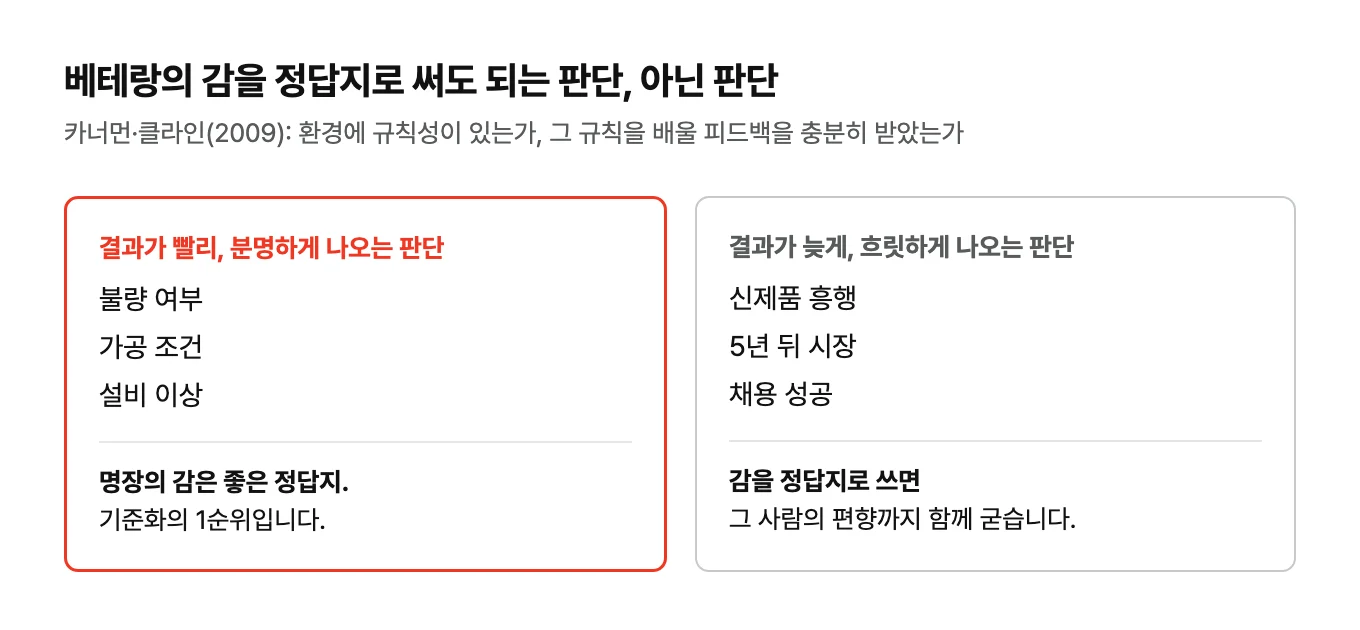
모든 베테랑의 감이 같은 품질은 아닙니다. 대니얼 카너먼과 게리 클라인은 직관을 두고 오랫동안 반대 입장에 서 있던 학자들인데, 6년 가까운 공동 작업 끝에 2009년 공동 논문에서 한 가지에 합의했습니다. 직관을 믿을 수 있는지는 두 가지로 가려진다는 것입니다. 판단이 내려지는 환경에 규칙성이 있는가, 그리고 그 사람이 그 규칙을 배울 피드백을 충분히 받았는가. 논문은 "주관적 확신은 판단 정확도의 믿을 만한 지표가 아니다"라고 못 박았습니다.
이것을 회사 일로 옮기면 기준이 선명해집니다.
- 결과가 빨리, 분명하게 나오는 판단(불량 여부, 가공 조건, 설비 이상): 명장의 감은 좋은 정답지입니다. 기준화의 1순위입니다.
- 결과가 늦게, 흐릿하게 나오는 판단(신제품 흥행, 5년 뒤 시장, 채용 성공): 감을 정답지로 쓰면 그 사람의 편향까지 함께 굳힙니다.
기준을 만들고 나면 기준이 원래 가르지 못하는 영역도 드러납니다. 조건이 거의 같은 사례들 사이에서는 점수 차이가 작게 나올 수밖에 없습니다. 이때 화면의 색이나 순위로 차이를 부풀리면 구분되지 않는 것을 구분되는 척하게 됩니다. "이 범위에서는 기준이 우열을 가리지 못한다"고 적어 두는 것도 기준의 일부입니다.
그래서 첫 버전의 기준은 "이것이 최선"을 고르는 판정기보다 "이것은 확실히 아니다"를 걸러내는 체로 쓰시는 편이 안전합니다.
원칙 셋. 숙련자를 데이터 제공자가 아니라 검수자로 모시십시오
암묵지 프로젝트가 가장 자주 무너지는 곳은 기술이 아니라 사람입니다.
1편에서 소개한 프레스 공정 과제는 결과물의 기준을 "명장 검수를 거친 골든 데이터셋 1,500건 이상"으로 잡았습니다. 숙련자가 데이터를 내놓는 사람이 아니라 무엇이 정답인지 확정하는 사람으로 들어가 있는 구조입니다.
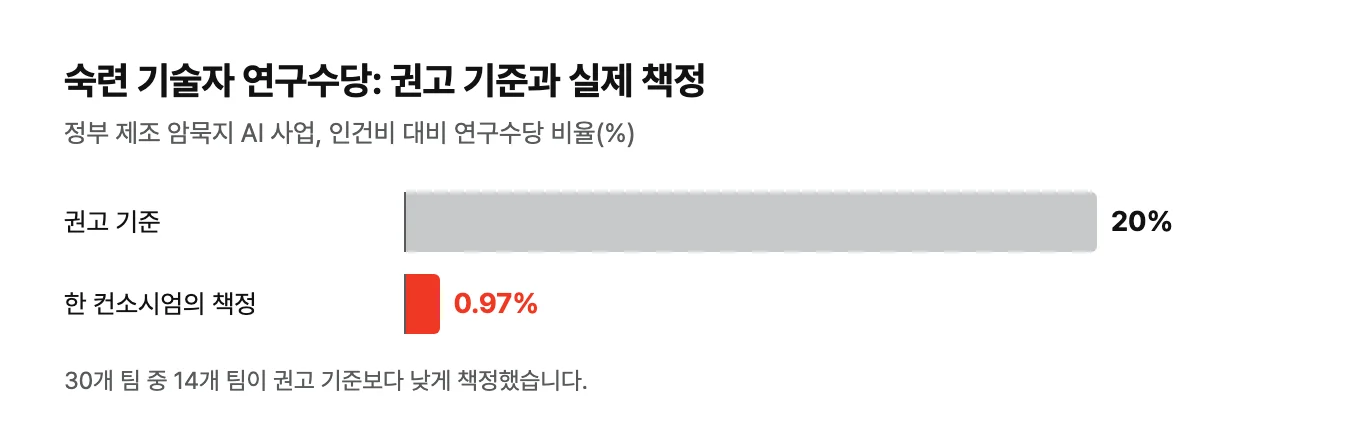
반대 사례도 있습니다. 같은 정부 사업에서 숙련 기술자에게 줄 연구수당은 인건비의 20%가 권고 기준이었지만, 산업일보 보도에 따르면 30개 팀 중 14개 팀이 그보다 낮게 책정했고, 한 컨소시엄은 0.97% 수준이었습니다. 49명이 참여한 한 팀에 배정된 총액이 594만 원이었다는 사례도 나왔습니다. 평생 쌓은 노하우를 꺼내 달라고 하면서 이 정도 대우라면, 나오는 것은 매뉴얼에 이미 적힌 내용뿐일 가능성이 큽니다.
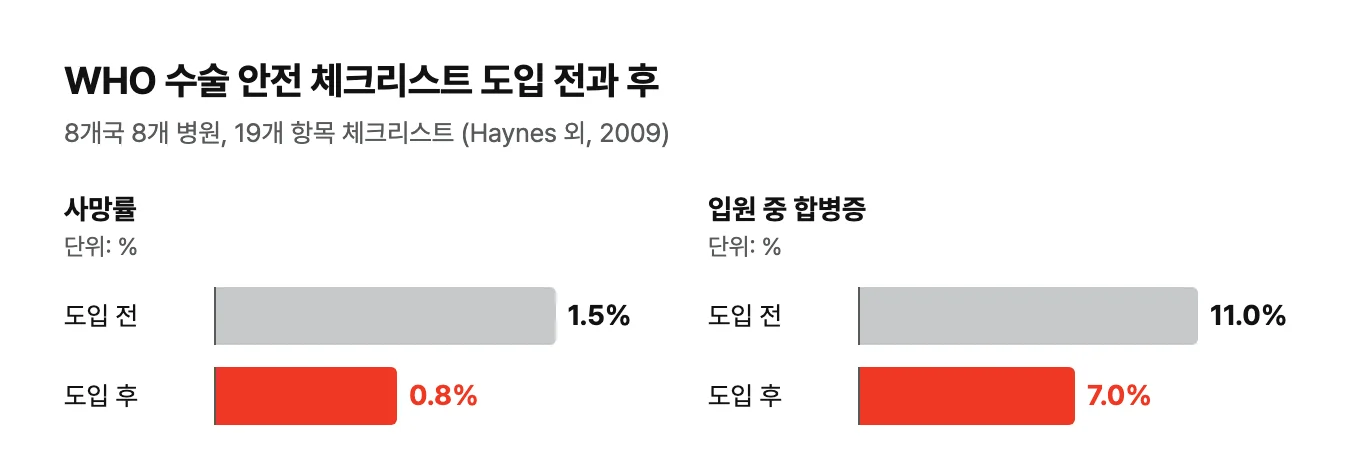
전문가가 기준을 쥐고 있을 때 결과가 좋아진다는 근거도 있습니다. 세계보건기구가 만든 19개 항목의 수술 안전 체크리스트를 8개국 8개 병원에 도입한 2009년 연구에서 사망률은 1.5%에서 0.8%로, 입원 중 합병증은 11.0%에서 7.0%로 줄었습니다. 체크리스트가 외과의를 대신한 것이 아닙니다. 숙련자들이 늘 하던 확인을 말로 꺼내 모두가 같은 순서로 하게 만든 것입니다.
AI로 기준을 만들 때 사람의 역할이 어떻게 바뀌는지는 AX, 사람의 역할은 어떻게 바뀌는가에서 더 다뤘습니다.
하나 더, 기준을 한 번 만들고 묶어 두지 마십시오. 원자재가 바뀌고 설비가 바뀌면 감도 바뀝니다. 숙련자는 그 변화를 몸으로 따라가지만, 문서로 굳힌 기준은 따라가지 못합니다. 분기에 한 번이라도 기준과 현장 판단이 갈린 사례를 모아 다시 맞추는 자리를 두십시오. 이 자리를 주재하는 사람도 숙련자여야 합니다.
실행 순서: 감 하나를 기준으로 바꾸는 여덟 단계
- 판단 하나를 고릅니다. 자주 반복되고, 결과가 빨리 확인되며, 그 사람이 없으면 멈추는 판단이 좋습니다.
- 옆에서 관찰하고 묻습니다. "왜 지금 멈추셨습니까", "무엇이 보였습니까"를 그 자리에서 묻고 녹음하십시오. 회의실 인터뷰보다 현장이 낫습니다.
- 조건 5~8개로 쪼개 이름을 붙입니다. 숙련자가 쓰는 말을 그대로 이름으로 쓰면 저항이 줄어듭니다.
- 조건마다 측정 방법과 데이터 출처를 적습니다. 없는 데이터는 따로 표시합니다.
- 가중치 초안을 만들고 숙련자와 함께 조정합니다. 가중치는 화면이나 문서에 드러나 있어야 합니다.
- 지난 사례로 대조합니다. 결과를 아는 사례를 넣어 기준과 숙련자의 판단이 어디서 갈리는지 봅니다. 방법은 AI가 만든 것을 어떻게 검증하십니까에 정리해 두었습니다.
- 기준이 가르지 못하는 영역을 문서로 남깁니다. "이 조건에서는 사람이 봐야 한다"는 문장도 기준입니다.
- 숙련자의 이름과 보상을 기준에 붙입니다. 누가 만든 기준인지 남아 있어야 고칠 때 물어볼 사람이 있습니다.
정리하면
쪼갠 조건을 합칠 때는 가중치를 드러내고, 감을 믿을 수 있는 영역을 가르고, 숙련자를 검수자로 세우십시오. 그러면 AI가 쓸 수 있는 기준이 되고, 그분이 은퇴한 뒤에도 회사에 남습니다.
기준을 만드는 일은 숙련자를 대체하는 작업이 아니라, 숙련자가 아는 것을 회사의 언어로 옮겨 적는 작업입니다. 그래서 기준의 마지막 검수자는 여전히 그분이어야 합니다.
이 주제를 직접 실험해 본 기록은 AI로 풍수 명당 찾기에 적어 두었습니다.
「베테랑의 감을 AI에 넘기는 법」 연재
- 감을 잴 수 있는 조건으로 쪼개기
- 가중치를 드러내고 숙련자를 검수자로 세우기 (현재 글)
참고 자료
- Grove 외, Clinical versus mechanical prediction: a meta-analysis (2000)
- Kahneman, Klein, Conditions for intuitive expertise: a failure to disagree (2009)
- 세계일보, 숙련공의 손길 AI로 데이터화… 명장의 감 다 살렸어 (2026)
- 산업일보, 제조 암묵지 AI 데이터화 사업, 숙련 기술자 보상 기준은 미흡 (2026)
- Haynes 외, A surgical safety checklist to reduce morbidity and mortality in a global population, NEJM (2009)