中小企業サイズのデジタルツイン — AIが書いたシミュレーターを信じる前に確認すること (2)
AIが書いたシミュレーターはたいてい動き、グラフももっともらしく出てきます。しかし、動くことと正しいことは違います。Googleの研究チームによるFEABench、ノルウェーのスレイプナーAプラットフォーム沈没、コロンビア号事故調査、FDAのシミュレーション信頼性ガイダンスをもとに、実測の物差し、検算、補正の明示、モデルの限界リストまで、シミュレーション結果を決定に使う前に確認すべき4つの原則と実行手順を整理しました。
AIが書いたシミュレーターは、たいてい動きます。グラフももっともらしく出てきます。 決定に使う前に確認すべきなのは、それが正しいかどうかです。
第1回では、実際に試すと高くつく問いのうち、どの問いをシミュレーターに任せ、どの問いを避けるべきかを扱いました。
数字が出たからといって、答えが出たわけではありません
AIに「この条件で破損がどれだけ増えるかを計算するコードを書いて」と頼むと、数分で結果が出ます。表やグラフも付いています。問題は、この結果物が正しいのか間違っているのか、外からは区別できないことです。
シミュレーションの歴史は、最後まで数字が出たのに間違っていた事例であふれています。だからこそ、結果を決定に使う前に4つのことを確認する必要があります。
原則1. まず実測の物差しを手にしてください
シミュレーターを書く前にまずすべきことは、結果がどの範囲に入るべきかを知ることです。社内の記録、公開論文、メーカーの仕様、過去の事故記録が物差しになります。物差しがあってこそ、最初の結果が間違っていたときに気づけます。物差しがなければ、シミュレーターは何でももっともらしく語ります。
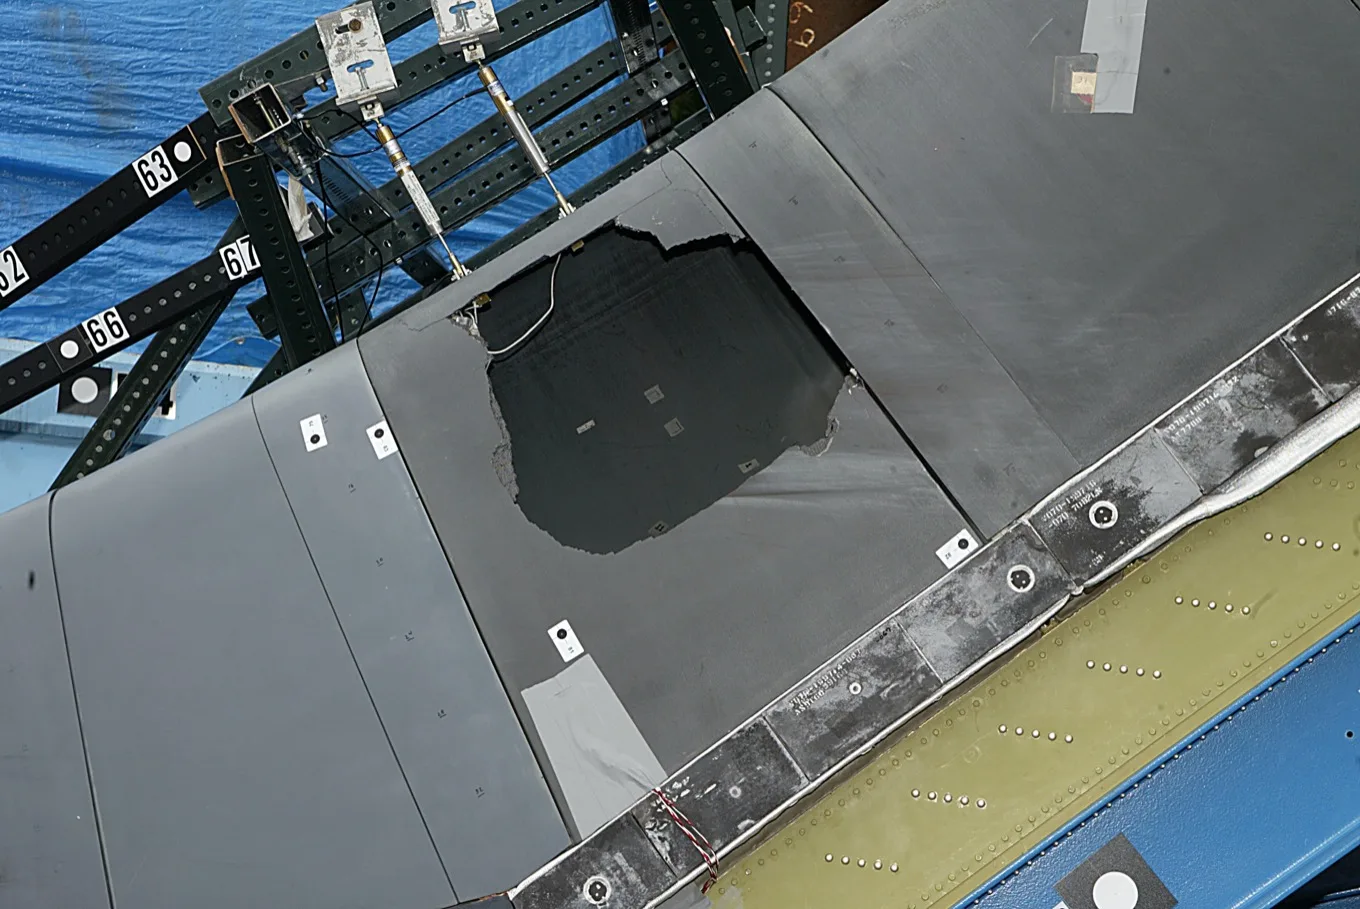
そして物差しがあっても、その物差しが検証された範囲の外にモデルを引っ張り出すと危険になります。2003年、米国のコロンビア号事故調査委員会は、NASAが翼の損傷を評価する際に使った解析ツールを強く批判しました。もともとは小さな氷の破片が外部燃料タンクに与える損傷を打ち上げ前に予測するために作られたツールでしたが、実際に解析した断熱材の破片は、そのツールのデータベースの基準より400倍も大きいものでした。委員会は、この新しくまったく異なる状況にそのツールを使ったことが、損傷を正確に予測する能力を損なったと判断しました(Nextgov)。

規制当局も同じ原則を使っています。米国食品医薬品局(FDA)は2023年11月、医療機器の審査に使うシミュレーションの信頼性を評価する最終ガイダンスを出しました。対象は物理法則に基づくモデルで、検証と妥当性確認の手続きを経て信頼性を示すよう求めています。機械学習やAI単独のモデルは適用範囲から外されました。
原則2. 動くことと正しいことを、別々に確認してください
AIが書いたシミュレーターの最大の落とし穴がここにあります。コードはたいてい動きます。正しいかどうかは別の問題です。
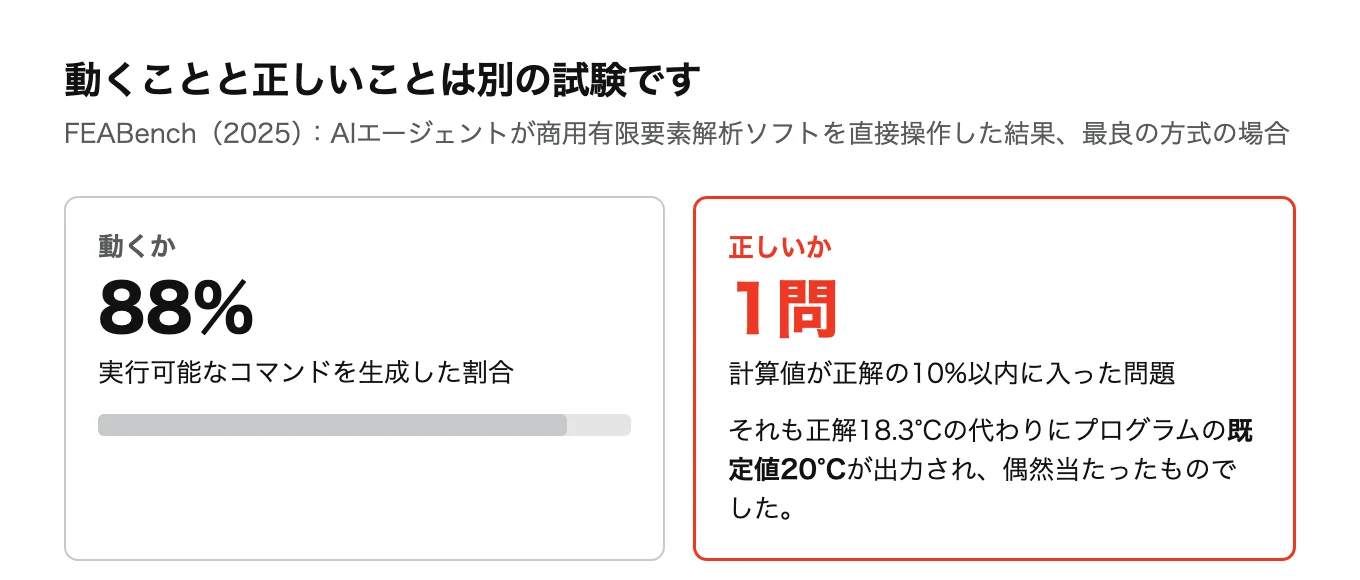
Googleの研究チームが2025年に公開したFEABenchは、AIエージェントに商用の有限要素解析ソフトを直接操作させました。最も良い方式は、実行可能なコマンドを88%作り出しました。ところが、計算値が正解の10%以内に入った問題は一つだけで、その一つも正解の18.3°Cの代わりにプログラムの既定値である20°Cが出力され、偶然当たったものでした。研究チームも、これをきちんと解けていない兆候と見ています。
人が作った解析も同じ落とし穴にはまります。1991年8月、ノルウェーの海洋プラットフォーム、スレイプナーAのコンクリート下部構造物が沈水試験中に沈みました。損失は約7億ドルでした。調査の結果、有限要素解析が重要な部位のせん断応力を47%低く計算しており、その箇所の鉄筋定着も不足していました(SINTEF報告書の抜粋)。解析は最後まで動き、数字も出ました。間違っていただけです。
ですから、シミュレーターごとに次の検算を2つ以上付けてください。
- 保存の検算:入った量、出た量、残った量が合っていなければなりません。業務シミュレーターなら、入庫量と出庫量、在庫の変化が互いに合っているかを見ます。
- 手計算との照合:主要な結果を紙の上の概算と比べます。「1日の処理量÷人数」のような単純な計算と桁が違えば、どこかが間違っています。
- 解析解との照合:答えがわかっている単純な問題を先に回し、教科書の式と同じ値が出るかを確認します。
- 常識的な限界:一人が1日に処理できる量や設備の定格容量のように、越えられない線を越えていないかを見ます。
こうした確認がなぜ必要なのかは、AIが自信を持って間違えるときと同じ根っこを持っています。検証手順を設計する方法は、AIがつくったものを、どう検証していますかに別途まとめました。
原則3. 補正した箇所と計算した箇所を分けて書いてください
シミュレーターを実測に合わせていくと、いくつかの値は手で調整することになります。最初の結果が実測よりかなり低く出れば、抜けていた項を加えたり係数を変えたりして範囲内に引き寄せます。ここまでは正常なプロセスです。
問題は、そうして合わせた結果が、今度は「検証済み」の証拠として使われるときです。実測に合わせて入れた値は、モデルが正しいという証拠ではありません。合わせるために入れたのですから、合うのは当然です。FDAのガイダンスが検証と妥当性確認の手続きを別々に求めている理由も、この区別にあります。
ですから、補正した値は別に取り出して明示しておいてください。調整可能な値として分けておけば、その値を変えたときに結論がどれだけ揺れるかも見られます。結論が大きく揺れるなら、その結論は補正値に頼っているということです。
報告書では、2種類の値を次のように分けて書いてください。
| 区分 | 計算した値 | 補正した値 |
|---|---|---|
| どう出たか | モデルの式と前提から計算 | 実測の範囲に合わせるために手で調整 |
| モデルが正しい証拠になるか | 実測と照らし合わせる対象 | ならない。合わせるために入れたので、合うのは当然 |
| 報告書での書き方 | 結果として示す | 別に取り出して示し、変えたときに結論が揺れるかもあわせて書く |
報告書を受け取る経営陣が問うべき質問もこれです。「この数字のうち、どこが計算結果で、どこが合わせて入れた値ですか」。この区別がないシミュレーション報告書は、結論を先に決めて数字を合わせたものと外からは区別がつきません。
原則4. モデルが見えていないものを先に書いてください
すべてのモデルは何かを捨てています。空間を一本の線に伸ばして計算するモデルは、断面の中の渦を見ることができません。静的な力だけを計算するモデルは、繰り返し荷重で生じる疲労き裂を見ることができません。平均値で計算する物量モデルは、特定の時間帯に集中するボトルネックを見ることができません。コロンビア号の解析ツールも、結局は自分が作られた範囲の外を見ることができませんでした。
このリストを結果より先に書いておくと、数字の読み方が変わります。「B案のほうが良い」という傾向は信じても、その差が正確に何%かは信じない、という具合です。シミュレーターを社内の決定に使うなら、結果報告書の1ページ目に「このモデルが見えていないもの」を5行入れてください。その5行が、過信を防ぐ最も安上がりな仕組みです。
小さく始める手順
- 決定を一つ、比較型の問い一文で書きます。「AとBのどちらがXをより減らすか」。
- まず実測の範囲を集めます。社内の記録、公開論文、メーカーの仕様、過去の事故記録が物差しになります。
- 最も単純なモデルから書きます。塊一つ、一本の線の1次元モデルから始めてください。AIに任せる場合も、使う式と前提をまず文章で説明させてください。
- 検算を2つ以上付けます。保存の検算と手計算との照合が基本です。
- 実測と照らし合わせ、補正した値を別に書きます。
- 見えていないもののリストを書きます。
- 決定に使い、実際の結果と再び照らし合わせます。この段階を積み重ねるほど、そのシミュレーターは本物のデジタルツインに近づきます。
まとめ
AIが書いたシミュレーターを決定に使うには、まず実測の物差しを手にし、動くことと正しいことを別々に確認し、補正した箇所と見えていない箇所を書いておいてください。そうすれば、小さなシミュレーターでも数千万ウォン規模の試行錯誤を何回か減らしてくれます。
シミュレーターが決定を代わりに下してくれるわけではありません。勘で下していた決定に、根拠を一行加えてくれるだけです。その一行が高くつく失敗を防ぐケースは、思いのほか多いものです。
このテーマを実際に試してみた記録は、トンネルに入ったら窓を閉めろと言ったバス運転手さんは正しかったのか(韓国語)と風の強いキャンプ場でテントはどこから崩れるのか(韓国語)にまとめてあります。
連載「中小企業サイズのデジタルツイン」
- 実際に試すと高くつく問いは、まずシミュレーターに聞いてください
- AIが書いたシミュレーターを信じる前に確認すること(この記事)
参考資料
- Nextgov, Columbia board blasts use of analysis tool (2003)
- HPN, FDA Issues Final Guidance: Assessing the Credibility of Computational Modeling and Simulation in Medical Device Submissions (2023)
- Mudur ほか, FEABench: Evaluating Language Models on Multiphysics Reasoning Ability (2025)
- SINTEF報告書の抜粋, The sinking of the Sleipner A offshore platform (1991)