中小企业规模的数字孪生 — 相信AI写的仿真器之前要确认的事 (2)
AI写的仿真器通常都能跑起来,图表看上去也像模像样。但能运行和算得对是两回事。本文依据谷歌研究团队的FEABench、挪威Sleipner A平台沉没事故、哥伦比亚号事故调查以及FDA关于仿真可信度的指南,梳理在把仿真结果用于决策之前要确认的四项原则和实施顺序:实测参照、验算、标明校准值、列出模型的盲区。
AI写的仿真器通常都能跑起来,图表看上去也像模像样。 用于决策之前要确认的,是它算得对不对。
在第1篇中,我们讨论了在实地试一次代价高昂的问题里,哪些适合交给仿真器、哪些应该避开。
有了数字,不等于有了答案
让AI“写一段代码,算一算在这个条件下破损会增加多少”,几分钟就能出结果,还附带表格和图表。问题在于,从外表上看不出这个结果是对是错。
仿真的历史中,充满了数字一直算到最后、结果却是错的案例。所以,在把结果用于决策之前,需要确认四件事。
原则一:先把实测参照握在手里
写仿真器之前,第一件事是弄清结果应该落在什么范围内。公司内部记录、公开论文、厂商规格、过去的事故记录,都可以作为参照。有了参照,第一次结果出错时才能察觉;没有参照,仿真器说什么都显得有道理。
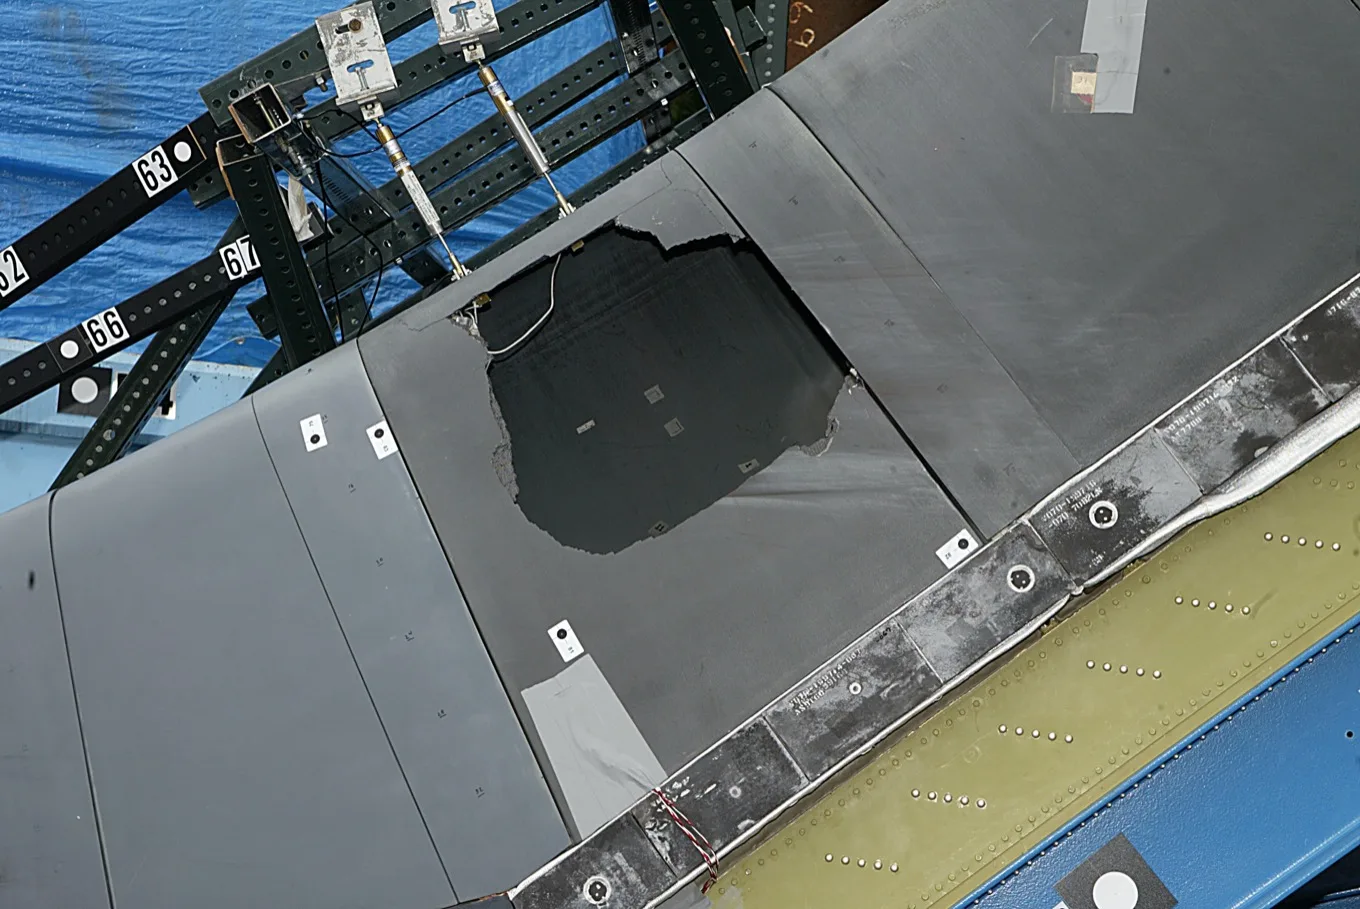
而且即使有参照,把模型拉到参照经过验证的范围之外也会变得危险。2003年,美国哥伦比亚号事故调查委员会严厉批评了NASA评估机翼损伤时使用的分析工具。这个工具原本是为了在发射前预测小冰块对外部燃料箱造成的损伤而开发的,但实际分析的隔热泡沫块,比该工具数据库的基准大了400倍。委员会认定,在这种全新且完全不同的情况下使用这个工具,损害了它准确预测损伤的能力(Nextgov)。

监管机构也遵循同样的原则。美国食品药品监督管理局(FDA)于2023年11月发布了评估医疗器械审评中所用仿真可信度的最终指南。适用对象是基于物理定律的模型,要求通过验证与确认程序来证明其可信度。机器学习或单独的AI模型被排除在适用范围之外。
原则二:分别确认“能运行”和“算得对”
AI写的仿真器最大的陷阱就在这里。代码通常都能跑,对不对是另一回事。
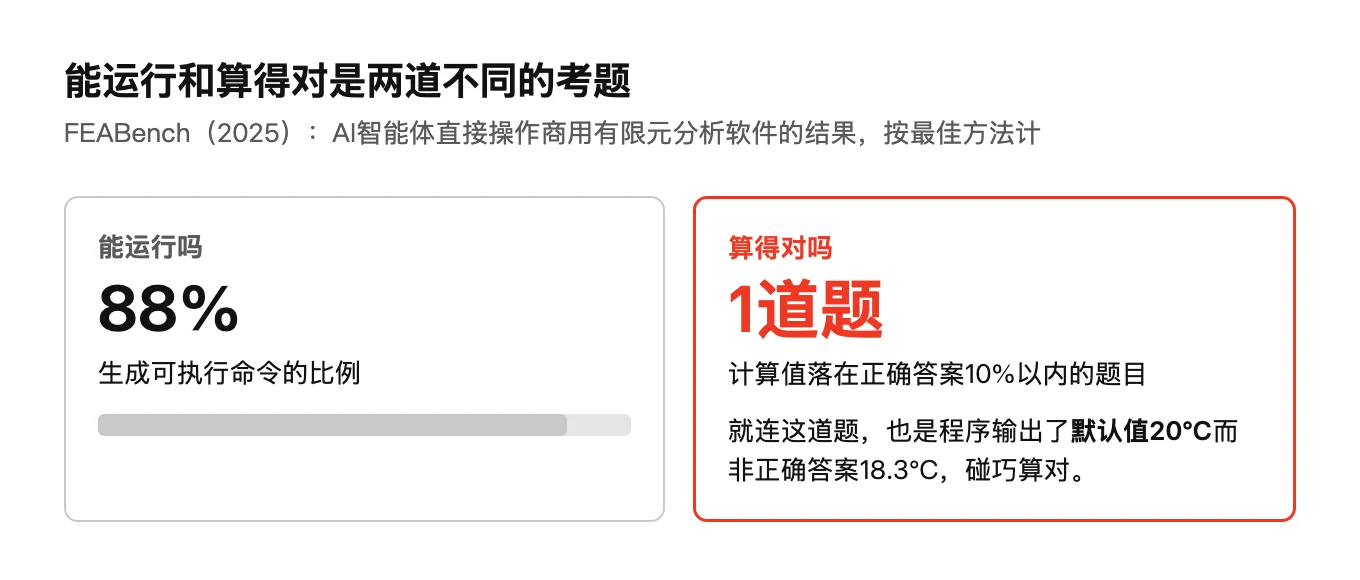
谷歌研究团队2025年发布的FEABench,让AI智能体直接操作商用有限元分析软件。最佳方法生成的命令有88%可以执行。然而,计算值落在正确答案10%以内的题目只有一道,而且这一道也是程序输出了默认值20°C而非正确答案18.3°C,碰巧算对的。研究团队也把这看作没有真正解出来的信号。
人做的分析也会掉进同样的陷阱。1991年8月,挪威海上平台Sleipner A的混凝土下部结构在沉放试验中沉没,损失约7亿美元。调查发现,有限元分析把关键部位的剪应力算低了47%,而且那个位置的钢筋锚固也不足(SINTEF报告摘录)。分析一直跑到了最后,数字也算出来了,只是错了。
所以,每个仿真器都要配上下面至少两种验算。
- 守恒验算:进来的量、出去的量和剩下的量必须对得上。如果是业务仿真器,就看入库量、出库量和库存变化是否相互吻合。
- 手算对照:把关键结果和纸上的粗算比一比。如果和“日处理量除以人数”这类简单计算差了一个数量级,一定是哪里错了。
- 解析解对照:先跑一个答案已知的简单问题,确认能得到和教科书公式一样的值。
- 常识上限:检查结果有没有越过不可能越过的线,比如一个人一天能处理的量、设备的额定容量。
为什么需要这些确认,和当 AI 自信满满地出错是同一个根源。设计验证流程的方法,另外整理在AI 做出来的东西,你怎么验证中。
原则三:把校准过的地方和计算出来的地方分开写
让仿真器去吻合实测时,难免要手动调整一些数值。第一次结果比实测低很多时,就会补上漏掉的项、或者改动系数,把结果拉回范围内。到这里为止都是正常的过程。
问题在于,这样凑出来的结果又被当作“已经验证”的证据。为吻合实测而填进去的数值,不是模型正确的证据。本来就是为了吻合才填进去的,吻合是理所当然的。FDA指南之所以分别要求验证和确认程序,原因也在于这个区分。
所以,请把校准过的数值单独拿出来标明。把它们分离成可调整的数值后,还能看到改变这些数值时结论会动摇多少。如果结论动摇得很厉害,说明这个结论依赖的是校准值。
在报告中,请像下面这样把两类数值分开写。
| 区分 | 计算出来的值 | 校准过的值 |
|---|---|---|
| 怎么来的 | 由模型的公式和假设计算得出 | 为吻合实测范围而手动调整 |
| 能否证明模型正确 | 是需要与实测对照的对象 | 不能。本来就是为了吻合才填进去的,吻合理所当然 |
| 报告中的写法 | 作为结果呈现 | 单独标出,并写明改动后结论是否动摇 |
拿到报告的管理层应该问的也是这个问题:“这些数字里,哪些是计算结果,哪些是凑进去的值?”没有这个区分的仿真报告,从外表上看,和先定结论再凑数字的报告没有区别。
原则四:先写下模型看不到的东西
所有模型都会舍弃一些东西。把空间压成一条线来计算的模型,看不到截面内部的涡流;只计算静力的模型,看不到反复荷载下产生的疲劳裂纹;用平均值计算的物量模型,看不到集中在特定时段的瓶颈。哥伦比亚号的分析工具,最终也看不到它被设计的范围之外。
把这份清单写在结果之前,读数字的方式就会改变。可以相信“B方案更好”这个趋势,但不相信差距具体是百分之几。如果要把仿真器用于公司决策,请在结果报告第一页写上五行“这个模型看不到的东西”。这五行,是防止过度自信最便宜的装置。
从小处起步的顺序
- 把一个决定写成一句比较型问题。“A和B哪个更能减少X?”
- 先收集实测范围。公司内部记录、公开论文、厂商规格、过去的事故记录都可以作为参照。
- 从最简单的模型写起。从一个整体块、一条线的一维模型开始。交给AI时,也要先让它用文字说明所用的公式和假设。
- 配上至少两种验算。守恒验算和手算对照是基本功。
- 与实测对照,把校准过的值单独写出来。
- 写出模型看不到的东西的清单。
- 用于决策,再用实际结果对照一次。这一步积累得越多,这个仿真器就越接近真正的数字孪生。
小结
要把AI写的仿真器用于决策,请先握住实测参照,分别确认能运行和算得对,并写下校准过的地方和看不到的地方。这样,即使是小小的仿真器,也能帮你省下几次上千万韩元的试错。
仿真器不会替你做决定,它只是给原本凭直觉做出的决定,多添一行依据。而这一行依据能避免昂贵失误的情况,比想象中多得多。
我亲自就这个主题做实验的记录,写在了터널에 들어가면 창문을 닫으라던 버스 기사님은 옳았을까(让我们进隧道就关窗的公交司机说得对吗)(韩语)和바람 부는 캠핑장에서 텐트는 어디부터 무너질까(大风营地里帐篷会从哪里先垮)(韩语)中。
“中小企业规模的数字孪生”系列
- 实地试一次代价高昂的问题,先问仿真器
- 相信AI写的仿真器之前要确认的事(本文)
参考资料
- Nextgov, Columbia board blasts use of analysis tool (2003)
- HPN, FDA Issues Final Guidance: Assessing the Credibility of Computational Modeling and Simulation in Medical Device Submissions (2023)
- Mudur 等, FEABench: Evaluating Language Models on Multiphysics Reasoning Ability (2025)
- SINTEF报告摘录, The sinking of the Sleipner A offshore platform (1991)