중소기업 크기의 디지털 트윈 — AI가 짠 시뮬레이터를 믿기 전에 확인할 것 (2)
AI가 짠 시뮬레이터는 대개 돌아가고 그래프도 그럴듯하게 나옵니다. 하지만 돌아가는 것과 맞는 것은 다릅니다. 구글 연구진의 FEABench, 노르웨이 슬레이프너 A 플랫폼 침몰, 컬럼비아호 사고 조사, FDA의 시뮬레이션 신뢰성 지침을 바탕으로 실측 잣대, 검산, 보정 표시, 모형의 한계 목록까지 시뮬레이션 결과를 결정에 쓰기 전 확인할 네 가지 원칙과 실행 순서를 정리했습니다.
AI가 짠 시뮬레이터는 대개 돌아갑니다. 그래프도 그럴듯하게 나옵니다. 결정에 쓰기 전에 확인할 것은 그것이 맞느냐입니다.
1편에서는 직접 해 보기 비싼 질문 가운데 어떤 질문을 시뮬레이터에 맡기고 어떤 질문은 피해야 하는지 다뤘습니다.
숫자가 나왔다고 답이 나온 것은 아닙니다
AI에게 "이 조건에서 파손이 얼마나 늘어나는지 계산하는 코드를 짜 달라"고 하면 몇 분 만에 결과가 나옵니다. 표와 그래프도 붙어 있습니다. 문제는 이 결과물이 맞는지 틀리는지 겉으로는 구별되지 않는다는 점입니다.
시뮬레이션의 역사는 숫자가 끝까지 나왔는데 틀렸던 사례로 가득합니다. 그래서 결과를 결정에 쓰기 전에 네 가지를 확인하셔야 합니다.
원칙 하나. 실측 잣대를 먼저 손에 쥐십시오
시뮬레이터를 짜기 전에 먼저 할 일은 결과가 어느 범위에 들어와야 하는지 아는 것입니다. 사내 기록, 공개 논문, 제조사 사양, 지난 사고 기록이 잣대가 됩니다. 잣대가 있어야 첫 결과가 틀렸을 때 알아챌 수 있습니다. 잣대가 없으면 시뮬레이터는 무엇이든 그럴듯하게 말합니다.
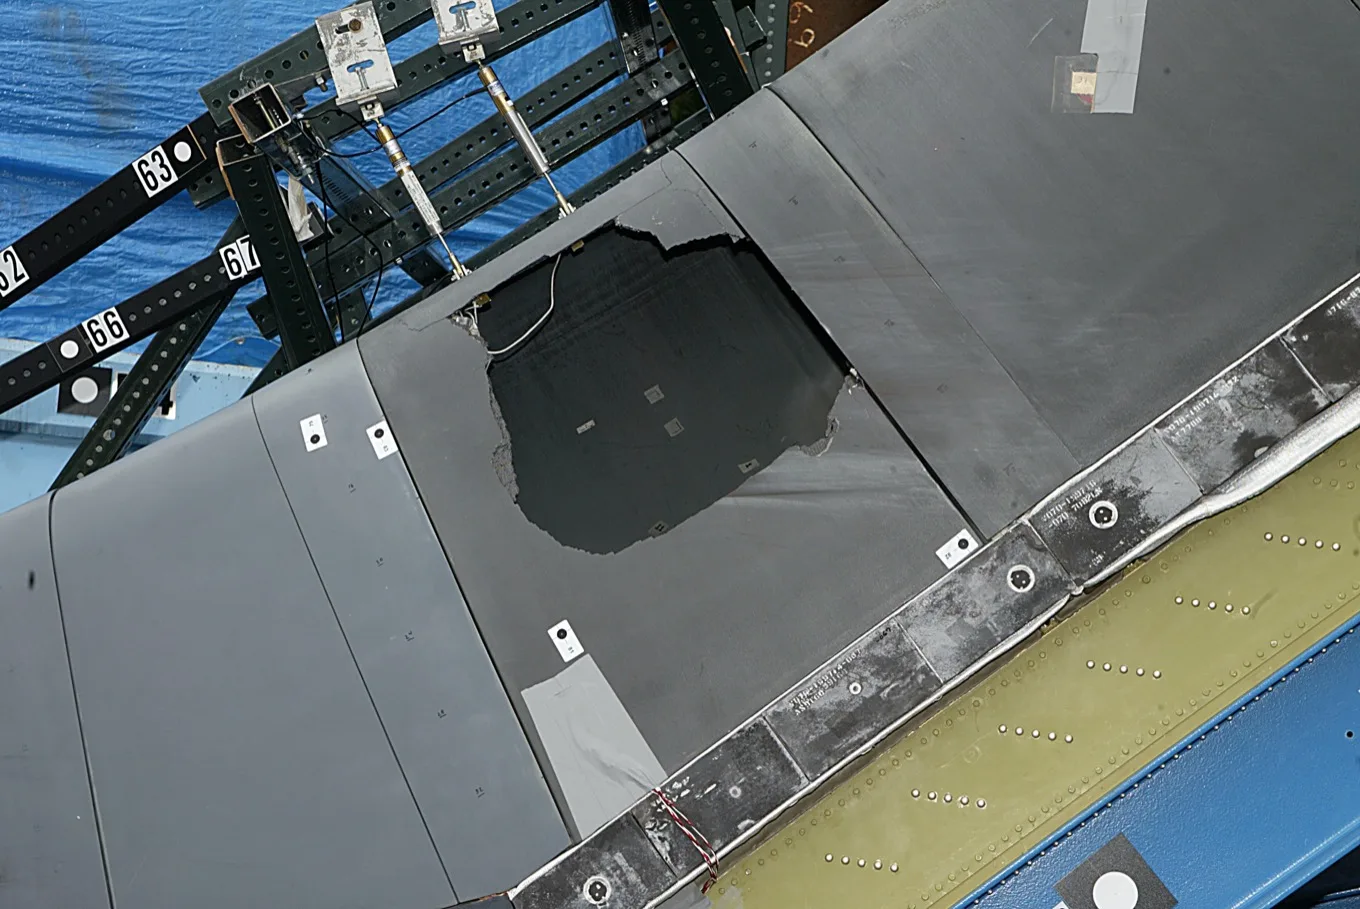
그리고 잣대가 있어도 그 잣대가 검증된 범위 밖으로 모형을 끌고 나가면 위험해집니다. 2003년 미국 컬럼비아호 사고 조사위원회는 NASA가 날개 손상을 평가할 때 쓴 해석 도구를 강하게 비판했습니다. 원래 작은 얼음 조각이 외부 연료 탱크에 주는 손상을 발사 전에 예측하려고 만든 도구였는데, 실제로 분석한 단열재 조각은 그 도구의 데이터베이스 기준보다 400배나 컸습니다. 위원회는 이 새롭고 전혀 다른 상황에 그 도구를 쓴 것이 손상을 정확히 예측하는 능력을 해쳤다고 판단했습니다(Nextgov).

규제 기관도 같은 원칙을 씁니다. 미국 식품의약국(FDA)은 2023년 11월 의료기기 심사에 쓰는 시뮬레이션의 신뢰성을 평가하는 최종 지침을 냈습니다. 대상은 물리 법칙에 기반한 모델이고, 검증과 확인 절차를 거쳐 신뢰성을 보이도록 했습니다. 머신러닝이나 AI 단독 모델은 적용 범위에서 뺐습니다.
원칙 둘. 돌아가는 것과 맞는 것을 따로 확인하십시오
AI가 짠 시뮬레이터의 가장 큰 함정이 여기 있습니다. 코드는 대개 돌아갑니다. 맞는지는 별개의 문제입니다.
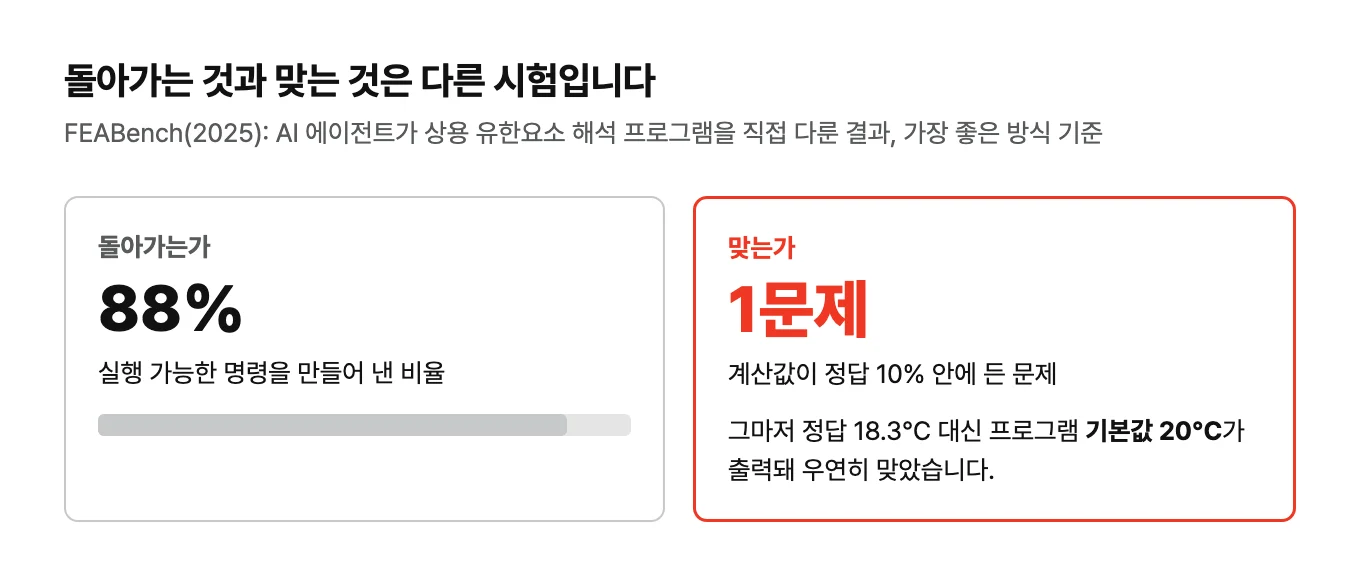
구글 연구진이 2025년 공개한 FEABench는 AI 에이전트에게 상용 유한요소 해석 프로그램을 직접 다루게 했습니다. 가장 좋은 방식은 실행 가능한 명령을 88% 만들어 냈습니다. 그런데 계산값이 정답 10% 안에 든 문제는 하나뿐이었고, 그 하나도 정답 18.3°C 대신 프로그램 기본값인 20°C가 출력돼 우연히 맞은 것이었습니다. 연구진도 이를 제대로 풀리지 않았다는 신호로 봤습니다.
사람이 만든 해석도 같은 함정에 빠집니다. 1991년 8월 노르웨이의 해양 플랫폼 슬레이프너 A의 콘크리트 하부 구조물이 침수 시험 중 가라앉았습니다. 손실은 약 7억 달러였습니다. 조사 결과 유한요소 해석이 핵심 부위의 전단 응력을 47% 낮게 계산했고, 그 자리의 철근 정착도 부족했습니다(SINTEF 보고서 발췌). 해석은 끝까지 돌아갔고, 숫자도 나왔습니다. 틀렸을 뿐입니다.
그래서 시뮬레이터마다 검산을 두 가지 이상 붙이십시오.
- 보존 검산: 들어간 양, 나간 양, 남은 양이 맞아야 합니다. 업무 시뮬레이터라면 입고량과 출고량, 재고 변화가 서로 맞는지 봅니다.
- 손계산 대조: 핵심 결과를 종이 위의 어림셈과 견줍니다. "하루 처리량 나누기 인원" 같은 단순한 계산과 자릿수가 다르면 어딘가 틀린 것입니다.
- 해석해 대조: 답이 알려진 단순한 문제를 먼저 돌려, 교과서 공식과 같은 값이 나오는지 확인합니다.
- 상식 한계: 한 사람이 하루에 처리할 수 있는 양, 설비의 정격 용량처럼 넘을 수 없는 선을 넘지 않는지 봅니다.
이런 확인이 왜 필요한지는 AI가 자신 있게 틀릴 때와 같은 뿌리입니다. 검증 절차를 설계하는 방법은 AI가 만든 것을 어떻게 검증하십니까에 따로 정리했습니다.
원칙 셋. 보정한 곳과 계산한 곳을 나눠 적으십시오
시뮬레이터를 실측에 맞추다 보면 몇몇 값은 손으로 조정하게 됩니다. 처음 결과가 실측보다 한참 낮게 나오면, 빠진 항을 넣거나 계수를 바꿔 범위 안으로 끌어오게 됩니다. 여기까지는 정상적인 과정입니다.
문제는 그렇게 맞춘 결과가 다시 "검증됐다"는 증거로 쓰일 때입니다. 실측에 맞춰 넣은 값은 모형이 옳다는 증거가 아닙니다. 맞추려고 넣었으니 맞는 것이 당연합니다. FDA 지침이 검증과 확인 절차를 따로 요구하는 이유도 이 구분에 있습니다.
그래서 보정한 값은 따로 빼서 표시해 두십시오. 조정 가능한 값으로 분리해 두면, 그 값을 바꿨을 때 결론이 얼마나 흔들리는지도 볼 수 있습니다. 결론이 크게 흔들린다면 그 결론은 보정값에 기대고 있는 것입니다.
보고서에서는 두 값을 이렇게 나눠 적으십시오.
| 구분 | 계산한 값 | 보정한 값 |
|---|---|---|
| 어떻게 나왔나 | 모형의 공식과 가정으로 계산 | 실측 범위에 맞추려고 손으로 조정 |
| 모형이 옳다는 증거가 되나 | 실측과 대조해 볼 대상 | 아님. 맞추려고 넣었으니 맞는 것이 당연 |
| 보고서에 적는 법 | 결과로 표시 | 따로 빼서 표시하고, 바꿨을 때 결론이 흔들리는지 함께 적음 |
보고서를 받는 경영진이 물어야 할 질문도 이것입니다. "이 숫자 중 어디가 계산 결과이고, 어디가 맞춰 넣은 값입니까." 이 구분이 없는 시뮬레이션 보고서는 결론을 정해 놓고 숫자를 맞춘 것과 겉으로 구별되지 않습니다.
원칙 넷. 모형이 못 보는 것을 먼저 적으십시오
모든 모형은 무언가를 버립니다. 공간을 한 줄로 펴서 계산하는 모형은 단면 안의 소용돌이를 보지 못합니다. 정적인 힘만 계산하는 모형은 반복 하중에 생기는 피로 균열을 보지 못합니다. 평균값으로 계산하는 물량 모형은 특정 시간대에 몰리는 병목을 보지 못합니다. 컬럼비아호의 해석 도구도 결국 자기가 만들어진 범위 밖을 보지 못했습니다.
이 목록을 결과보다 먼저 적어 두면 숫자를 읽는 방식이 달라집니다. "B안이 더 낫다"는 경향은 믿되, 그 차이가 정확히 몇 %인지는 믿지 않는 식입니다. 시뮬레이터를 사내 결정에 쓴다면 결과 보고서 첫 장에 "이 모형이 보지 못하는 것" 다섯 줄을 넣으십시오. 그 다섯 줄이 과신을 막는 가장 싼 장치입니다.
작게 시작하는 순서
- 결정 하나를 비교형 질문 한 문장으로 적습니다. "A와 B 중 무엇이 X를 더 줄이는가."
- 실측 범위를 먼저 모읍니다. 사내 기록, 공개 논문, 제조사 사양, 지난 사고 기록이 잣대가 됩니다.
- 가장 단순한 모형부터 짭니다. 덩어리 하나, 한 줄짜리 1차원 모형으로 시작하십시오. AI에게 맡기되, 쓰는 공식과 가정을 문장으로 먼저 설명하게 하십시오.
- 검산을 두 가지 이상 붙입니다. 보존 검산과 손계산 대조가 기본입니다.
- 실측과 대조하고, 보정한 값을 따로 적습니다.
- 못 보는 것 목록을 씁니다.
- 결정에 쓰고, 실제 결과로 다시 대조합니다. 이 단계가 쌓이면 그 시뮬레이터가 진짜 디지털 트윈에 가까워집니다.
정리하면
AI가 짠 시뮬레이터를 결정에 쓰려면 실측 잣대를 먼저 쥐고, 돌아가는 것과 맞는 것을 따로 확인하고, 보정한 곳과 못 보는 곳을 적어 두십시오. 그러면 작은 시뮬레이터도 수천만 원짜리 시행착오 몇 번을 줄여 줍니다.
시뮬레이터가 결정을 대신해 주지는 않습니다. 감으로 내리던 결정에 근거 한 줄을 더해 줄 뿐입니다. 그 한 줄이 비싼 실수를 막는 경우가 생각보다 많습니다.
이 주제를 직접 실험해 본 기록은 터널에 들어가면 창문을 닫으라던 버스 기사님은 옳았을까와 바람 부는 캠핑장에서 텐트는 어디부터 무너질까에 적어 두었습니다.
「중소기업 크기의 디지털 트윈」 연재
- 직접 해 보기 비싼 질문은 시뮬레이터에 먼저 물으십시오
- AI가 짠 시뮬레이터를 믿기 전에 확인할 것 (현재 글)
참고 자료
- Nextgov, Columbia board blasts use of analysis tool (2003)
- HPN, FDA Issues Final Guidance: Assessing the Credibility of Computational Modeling and Simulation in Medical Device Submissions (2023)
- Mudur 외, FEABench: Evaluating Language Models on Multiphysics Reasoning Ability (2025)
- SINTEF 보고서 발췌, The sinking of the Sleipner A offshore platform (1991)