正解がわかっている偽データでまず試してください — 正解を仕込んだ試験問題を作る (1)
AIや自動測定システムを検証するには正解が必要ですが、現場のデータには正解がないことが多く、人が付けた正解もぶれます。そんなときは、正解をあらかじめ仕込んだ試験問題を先に作れます。第1回では、ワイン審査、ミステリーショッピング、ミューテーションテスト、合成細胞画像といった韓国内外の事例から、正解を仕込む方法と業務別の試験問題の作り方を整理しました。
正解のないデータでは、AIを採点できません。 そんなときは、正解を仕込んだ試験問題を先に作ってください。
採点する正解がありません
AI導入の検証段階でよく行き詰まるポイントがあります。結果を突き合わせる正解がないということです。
不良検出AIなら、過去の写真に「これは不良」と書かれたラベルが必要ですが、多くの現場には合格・不合格の記録しかなく、どの部位がなぜ不良だったのかは残っていません。書類分類AIなら人が分類した記録はありますが、その人の判断が正しかったかは誰にもわかりません。AI検証設計の回で「答えがすでに出ている事例を選んでください」とお伝えしましたが、そうした事例がそもそもない業務も多いのです。
人が付けた正解そのものがぶれることも問題です。米国カリフォルニア州立フェアのワインコンテストで、ロバート・ホジソン(2008)は審査員に知らせずに、同じボトルから注いだワイン3杯を30杯の中に紛れ込ませました。毎年65〜70人を試したところ、3杯に同じメダル等級内の点数を付けた審査員は10人に1人ほどでした。さらに別の10人に1人は、同じワインに銅メダルから金メダルまでを付けました。専門家の判定を正解として使う前に、その正解がどれほどぶれるのかを先に知る必要があるということです。
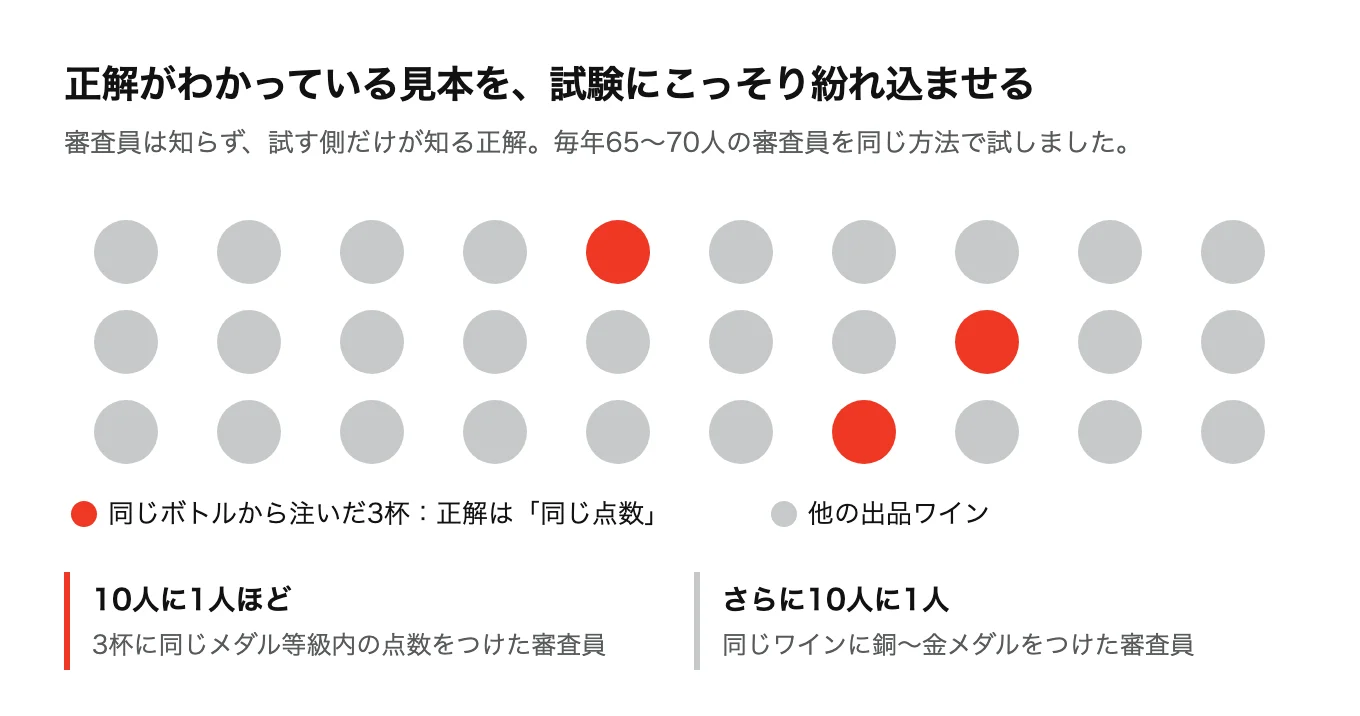
この実験で注目すべきは、結果より方法です。ホジソンは正解がわかっている見本を、試験の中にこっそり仕込みました。同じワインなので同じ点数が出るべきだという正解を、彼はあらかじめ知っていました。この連載は、この方法をAIの検証に移す話です。第1回では正解を仕込んだ試験問題の作り方を、第2回ではその試験問題を信頼できるものにする方法を扱います。
正解を仕込む方法は、すでに広く使われています
正解がわかっている偽物を混ぜてシステムを試す方法は、新しいものではありません。
韓国の金融業界にはミステリーショッピングがあります。金融監督院(日本の金融庁に相当)は調査員を顧客に見せかけて窓口へ送り、販売担当者が規定どおりに説明するかを点検します。2018年のデリバティブ連動証券の販売点検では、29の金融会社の440店舗を調査し、証券会社の平均83.9点、銀行の平均64.0点という結果(韓国語)を出しました。調査員がどんな顧客なのかを監督院が知っているので、その顧客に何を説明するのが正しいかもあらかじめ決まっています。正解がわかっている偽の顧客です。
ソフトウェア業界にはミューテーションテストがあります。コードにわざと小さなバグを仕込み、既存のテストがそのバグを捕まえるかを見ます。捕まえられなければ、テストが足りないということです。Googleはこの方法をコードレビューに組み込み、2万4千人を超える開発者、1,000を超えるプロジェクトで運用した結果を2021年の論文で公開しました。テストを試す試験問題を作ったわけです。
生命科学には、正解がファイル名に書かれた画像セットがあります。米国ブロード研究所のBBBC005は、シミュレーターで描いた細胞画像19,200枚で、1枚に細胞が1〜100個あり、焦点のぼけを段階的に変えながら描かれています。細胞の数がファイル名に入っているので、細胞を数えるアルゴリズムをすぐに採点できます。
| 事例 | 試される側 | 試す側が握っている正解 |
|---|---|---|
| ワイン審査(ホジソン、2008) | 審査員 | 同じボトルの3杯は同じ点数 |
| ミステリーショッピング(金融監督院、2018) | 販売担当者 | 調査員がどんな顧客で、何を説明されるべきか |
| ミューテーションテスト(Google、2021) | 既存のテスト | コードにわざと仕込んだ小さなバグ |
| BBBC005(ブロード研究所) | 細胞を数えるアルゴリズム | ファイル名に書かれた細胞の数 |
四つの事例の共通点は一つです。試す側が正解を握っていて、試される側はそれを知りません。
正解がわかっているデータを先に作ってください
検証の第一歩は、正解が何かを確実に知っているデータを確保することです。現場のデータで見つからなければ、作る必要があります。
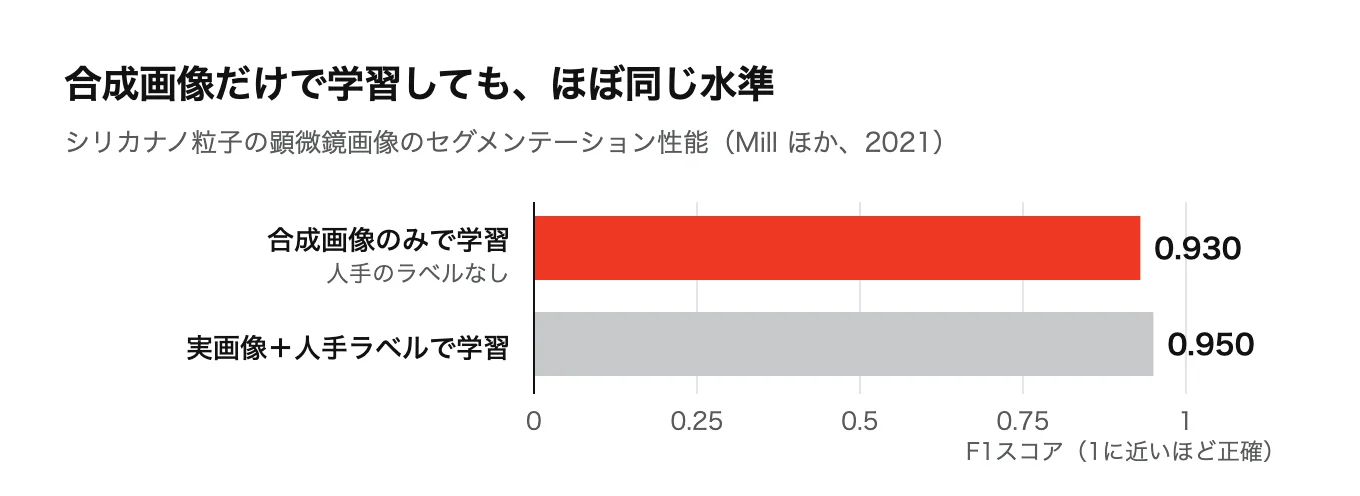
合成データは、研究の現場ではすでに実用段階に来ています。ナノ粒子の顕微鏡画像を3次元グラフィックスプログラムで描いて学習させたミルら(2021)の研究では、合成画像だけで学習したモデルがシリカ粒子のセグメンテーションでF1 0.930を記録しました。実画像に人がラベルを付けて学習したモデルは0.950でした。人が1枚ずつ輪郭を描く手間なしに、ほぼ同じ水準に達したのです。アンドリュー・ンもIEEE Spectrumのインタビューで、特定の不良タイプで性能が低いとき、合成データを作ればその問題をより狙って扱えると語っています。
中小企業の業務に置き換えるなら、大がかりである必要はありません。大きさがわかっている見本部品、わざと誤りを入れた見積書、正解の分類を決めておいた架空の問い合わせ数十件があれば始められます。肝心なのはデータの量ではなく、正解を自分が握っているという点です。
試験問題を作りやすい業務
業務ごとに、正解の仕込み方はこう変わります。
- 文書認識(OCR)・書類入力:金額、日付、取引先をあらかじめ決めた架空の見積書や領収書を作って印刷し、スキャンするかスマートフォンで撮って入れます。しわ、傾き、かすれた印影もわざと混ぜます
- 顧客問い合わせの分類:過去の問い合わせを参考に分類が明確な架空の問い合わせを書きますが、誤字脱字、略語、二つの要望が混ざった文を実際の比率どおりに入れます
- 不良検出:大きさと位置がわかっている欠陥を見本部品にわざと作るか、正常品の写真に欠陥の形を合成します
- 異常取引・不正検知:正常な取引記録の間にルール違反の事例をいくつか仕込み、何件見つけるかを数えます
どの場合でも、正解表は試験問題と別に保管する必要があります。正解がAIの入力に混ざってしまえば、試験ではなく書き取りになります。
正解表に書くこと
正解表は、合っていた・間違っていたを書くだけの表ではありません。後で何が点数を下げたのかを探すには、見本ごとの条件も一緒に書いておく必要があります。書類なら傾きとしわの程度、問い合わせなら誤字の数と要望がいくつ混ざっているか、部品なら欠陥の大きさと照明の角度です。この条件の欄があって初めて、第2回で扱う「条件を一つずつ揺らして原因を探る」作業ができます。
まとめると
現場のデータに正解がないからといって、検証をあきらめる必要はありません。正解がわかっている見本を作り、正解表を試験問題と別に置き、見本ごとに条件を書いておいてください。ワイン審査とミステリーショッピングが示すように、正解を握る側が試験を設計すれば、正解のない現場でも採点できます。試験問題を作るのにかかるコストは、たいてい失敗したパイロット1回分より小さいものです。既存データに正解の記録がどれほど残っているかを先に見たい場合は、データ状態点検の回もあわせてご参照ください。
次回は、その試験問題が実際の問題に似ているかを確かめる方法と、合成データでの点数を実物での検証につなげる順序を扱います。
連載「正解がわかっている偽データでまず試してください」
- 正解を仕込んだ試験問題を作る(この記事)
- 偽物が本物に似ているかを測る方法
参考資料
- Hodgson RT, An Examination of Judge Reliability at a major U.S. Wine Competition, Journal of Wine Economics (2008)
- 비즈니스워치, 금감원 파생결합증권 미스터리쇼핑 결과 (2018)(ビジネスウォッチ、金融監督院のデリバティブ連動証券ミステリーショッピング結果、韓国語)
- Petrović G ほか, Practical Mutation Testing at Scale: A view from Google (2021)
- Broad Institute, BBBC005 合成細胞画像セット
- Mill L ほか, Synthetic Image Rendering Solves Annotation Problem in Deep Learning Nanoparticle Segmentation (2021)
- IEEE Spectrum, Andrew Ng: Unbiggen AI (2022)