正解がわかっている偽データでまず試してください — 偽物が本物に似ているかを測る方法 (2)
正解を仕込んだ合成データでAIを試しても、偽物が本物に似ていなければ点数は水増しされます。第2回では、逆犯罪とドメインランダム化、ISOの画像解析規格、韓国の個人情報保護委員会の合成データ案内書をもとに、偽物と本物を同じ物差しで比べる方法、条件を一つずつ揺らして誤差の原因を探る方法、実物での検証で締めくくる実行手順を整理しました。
試験が易しければ、誰でも優等生になります。 合成データの点数を信じるには、まず試験問題が本物に似ているかを測ってください。
その試験問題は信頼できるか
第1回では、正解がわかっている見本を作って試験問題として使う方法を扱いました。試験問題ができれば、すぐに点数が出ます。しかし、点数が高く出たからといって安心するのはまだ早いのです。偽物を作った人とAIを作った人が同じ前提に立っていたなら、その点数は試験問題が易しかったという意味かもしれません。
今回は、試験問題そのものを検査する三つの原則と、初めて取り組むチームがよくするミス、そして実物での検証までつながる実行手順を扱います。
一つ目。偽物が本物に似ているかを先に測ってください
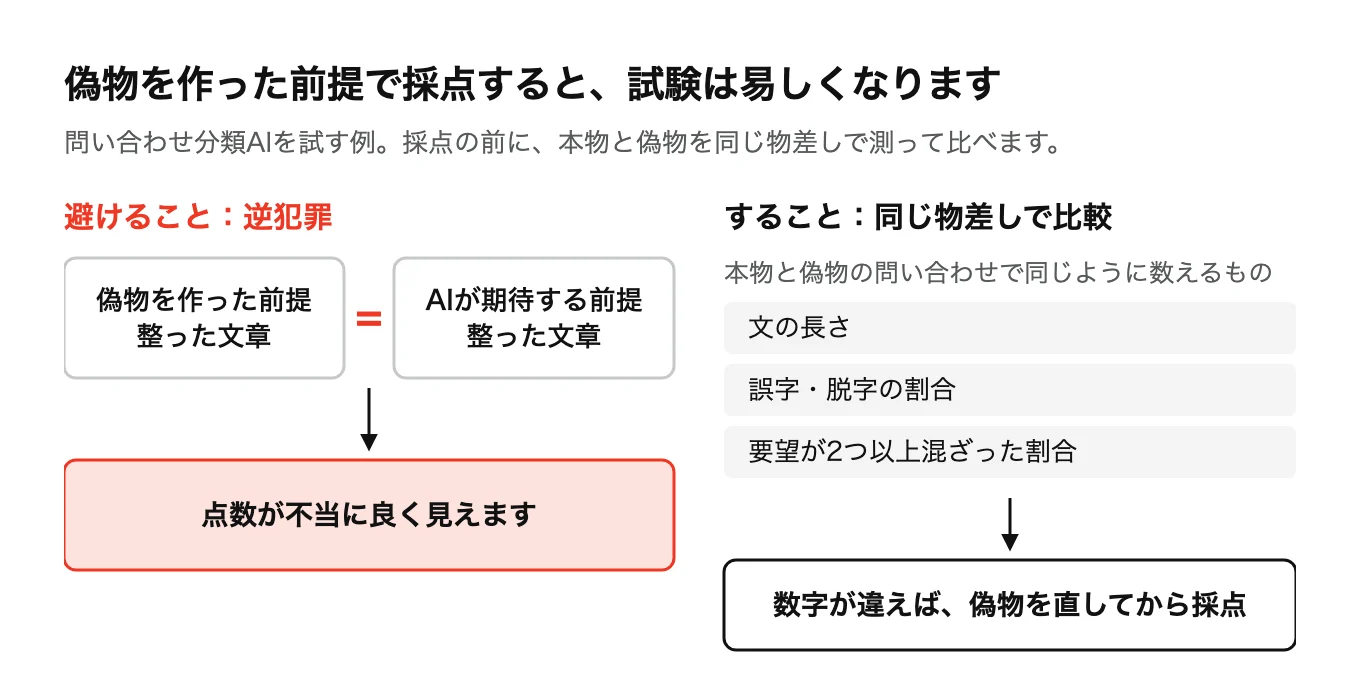
合成データによる検証で最もよくある落とし穴がここにあります。偽物を作るときに使った前提が、AIが期待する前提と同じなら、AIは試験を簡単に通過します。
数学の逆問題の分野には、これを指す言葉があります。データを合成するときと、そのデータを解くときに同じ理論的材料を使うことを逆犯罪(inverse crime)と呼び、結果が不当に良く見えるので避けるべきだと教えています。業務に置き換えるとこうです。問い合わせ分類AIを試すために整った文章だけで偽の問い合わせを書けば、整った文章を期待するAIは高い点数を取ります。実際の問い合わせに混ざっている誤字脱字、略語、一文に二つの要望が入ったケースは、試験問題にはありません。
ですから偽物を使う前に、本物と偽物を同じ物差しで測って比べる必要があります。問い合わせなら、文の長さ、誤字脱字の割合、要望が二つ以上混ざった割合を、本物と偽物で同じように数えます。画像なら、明るさの分布、ぼけの程度、物体が重なった割合を同じ方法で測ります。数字が違えば、偽物を直してから採点してください。
逆方向の処方もあります。ロボット学習分野のドメインランダム化(トービンら、2017)は、偽物を一つの本物に合わせる代わりに、質感や照明をきわめて幅広く揺らし、本物がその多くのバリエーションの一つに見えるようにします。この研究では、合成画像だけで学習した物体位置推定モデルが、実環境で1.5 cm前後の精度で動作しました。どちらの方法を使うにしても、問いは同じです。この試験問題は実際の問題に似ていますか。
二つ目。条件を一つずつ揺らして誤差の原因を探ってください
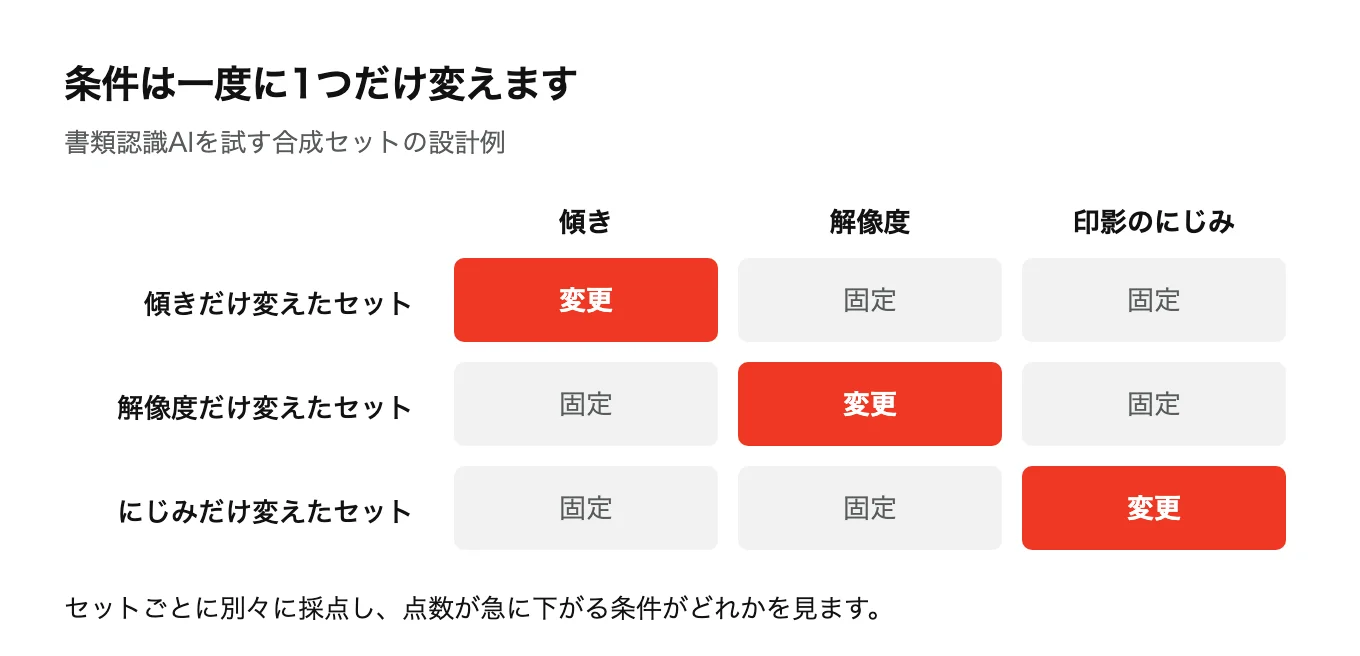
正解がわかっているデータの本当の価値は、点数一つではなく、何が点数を下げているのかを教えてくれる点にあります。現場のデータは条件が一度に変わるので原因を切り分けられませんが、合成データなら条件を一つずつだけ変えられます。
静止画像で粒子径を測る国際規格ISO 13322-1は、こうした実験を直接勧めています。接触している粒子を一つとして測ると誤差が生じ、画像解析だけではそれを見つけにくいことが多いので、1画面あたりの粒子数を増やしたり減らしたりしてその影響を確認せよというのです。規格が「条件を変えながら影響を測れ」と書いているわけです。
業務でも同じ方法が通用します。書類認識なら、傾きだけを変えたセット、解像度だけを変えたセット、印影のにじみだけを変えたセットを別々に作って採点します。どの条件で点数が急に下がるかが見えれば、直すべきなのがモデルなのか、撮影方法なのか、入力様式なのかが切り分けられます。
改善の効果を測るときも同じです。プロンプトを変えたりルールを直したりするたびに、同じ試験問題で採点し直してください。値を目分量で選ぶと、数枚の例でだけ良く見える設定が残りがちです。変えたことが本当に改善になったのかは、そうして初めてわかります。
三つ目。合成データでの点数は本当の点数ではありません
合成データによる検証は、実物での検証の代わりにはなりません。偽物で誤差15%というのは「本物に似せた偽物で15%」という意味であって、実際の現場で15%という意味ではありません。報告書でも二つの数字を区別して書く必要があります。
合成データを扱う韓国の指針も、同じ順序を強調しています。韓国の個人情報保護委員会は2024年12月に合成データ生成・活用案内書(韓国語)を公表し、事前準備、生成、安全性・有用性の検証、審議委員会による評価、活用と管理の5段階を示しました。個人情報保護が主目的の案内書ですが、作ったデータが元データの有用性をどれだけ保っているかを別途検証せよという要求は、AI試験用の合成データにもそのまま当てはまります。
現実的な順序はこうです。合成データで失敗のタイプと原因を先に見つけて直したうえで、正解がわかっている少数の実物見本で最終確認します。実物見本を100個作るコストは大きいですが、合成データで問題を先にふるい落としておけば、その100個をはるかに有効に使えます。
よく見るミス三つ
一つ目、きれいすぎる偽物を作ること。誤字のない問い合わせ、まっすぐ撮れた書類、離して置かれた部品のように、作りやすい偽物はたいていAIにとっても易しいものです。その点数は上限にすぎません。現場でいちばん厄介な事例をいくつか選び、その特徴をわざと偽物に入れてください。
二つ目、点数を一つだけ見ること。平均精度90%という数字は、何を見逃したのかを教えてくれません。見逃しはないのに2件を1件にまとめてしまったケースが多いのかもしれないし、ないものを見つけたケースが多いのかもしれません。当たったもの、見逃したもの、誤ってまとめたもの、ないのに見つけたものを別々に数えてください。
| 別々に数えるもの | 意味 |
|---|---|
| 当たったもの | 正解表と一致した結果 |
| 見逃したもの | 正解表にあるのに見つけられなかったもの |
| 誤ってまとめたもの | 2件を1件にまとめてしまったもの |
| ないのに見つけたもの | 正解表にないのに見つけたもの |
三つ目、同じ試験問題で直して評価すること。試験問題を見ながらルールを直していると、その試験問題にだけ合うルールになります。特に、偽物を作るときに使った特徴を基準にふるい分けるルールは、その偽物でいちばん良く見えるものです。直すときに使う試験問題と、評価するときに使う試験問題を分けておいてください。
実行手順
初めて取り組むなら、次の順序をお勧めします。
- 正解を決めます。何を当てるべきか、正解データをどんな形式で残すかを書きます
- 偽物を作ります。実際のデータからノイズ、照明、誤字脱字の割合といった条件を測って反映します
- 似ているかを測ります。本物と偽物を同じ物差しで測って統計を比べ、違えば偽物を直します
- 採点します。当たったもの、見逃したもの、誤ってまとめたものを別々に数えます
- 条件を揺らします。一度に一つずつ変えて、誤差を大きくする条件を探します
- 直して採点し直します。評価用の試験問題は別に置き、改善前後を比べます
- 実物で確認します。正解がわかっている少数の実物見本で最終点検し、合成データでの点数と実物での点数の差を記録します
パイロットから運用に移るとき、この試験問題はそのまま回帰テストのセットになります。モデルやプロンプトを変えるたびに同じ試験問題を回せば、性能が知らないうちに落ちるのを防げます。
運用中も試験問題は役に立ちます。ワイン審査で同じワインをこっそり混ぜたように、正解がわかっている見本を数件、実際の業務の流れに定期的に混ぜておいてください。毎週、試験用の見積書5枚をほかの書類と一緒に入れて結果を確認するといった形です。入力様式が変わったり、カメラの照明が劣化したりして性能が徐々に落ちるとき、この見本がいちばん先に知らせてくれます。人が行う検品も同じ方法で点検できます。運用成果をどんな指標で見るかは、成果測定の回で詳しく扱いました。
まとめると
試験問題が実際の問題に似ているかを先に確かめ、条件を一つずつ揺らして原因を探り、最後に実物で確認してください。同じAIでも、易しい試験問題では優等生、難しい試験問題では落第生になりえます。点数を信じるには、まず試験問題を信じられなければなりません。
このテーマを実際に実験した記録は、正解がわかっている偽のコーヒー(韓国語)に書いておきました。
連載「正解がわかっている偽データでまず試してください」
- 正解を仕込んだ試験問題を作る
- 偽物が本物に似ているかを測る方法(この記事)
参考資料
- Wirgin A, The inverse crime (2004)
- Tobin J ほか, Domain Randomization for Transferring Deep Neural Networks from Simulation to the Real World (2017)
- ISO, ISO 13322-1:2014 Particle size analysis, Image analysis methods, Part 1(公式サンプル)
- 뉴스서울, 개인정보보호위원회 합성데이터 안내서 마련 (2024)(ニュースソウル、個人情報保護委員会が合成データ案内書を策定、韓国語)