先用已知答案的假数据来测试 — 衡量假数据是否像真数据的方法 (2)
即使用埋好答案的合成数据测试AI,如果假数据不像真数据,分数也会被抬高。第2篇基于逆犯罪、域随机化、ISO图像分析标准以及韩国个人信息保护委员会的合成数据指南,整理了如何用同一把尺子比较真假数据、如何逐个改变条件找出误差原因,以及以实物验证收尾的执行步骤。
试卷太简单,谁都能当优等生。 要相信合成数据上的分数,先衡量这份试卷像不像真实问题。
这份试卷可信吗
第1篇讨论了制作已知答案的样本并把它当作试卷来用。有了试卷,分数马上就出来了。但分数高,还不到可以放心的时候。如果制作假数据的人和开发AI的人基于同样的假设,那这个分数可能只说明试卷太简单。
本篇讨论检验试卷本身的三条原则、初次尝试的团队常犯的错误,以及一直延伸到实物验证的执行步骤。
一、先衡量假数据像不像真数据
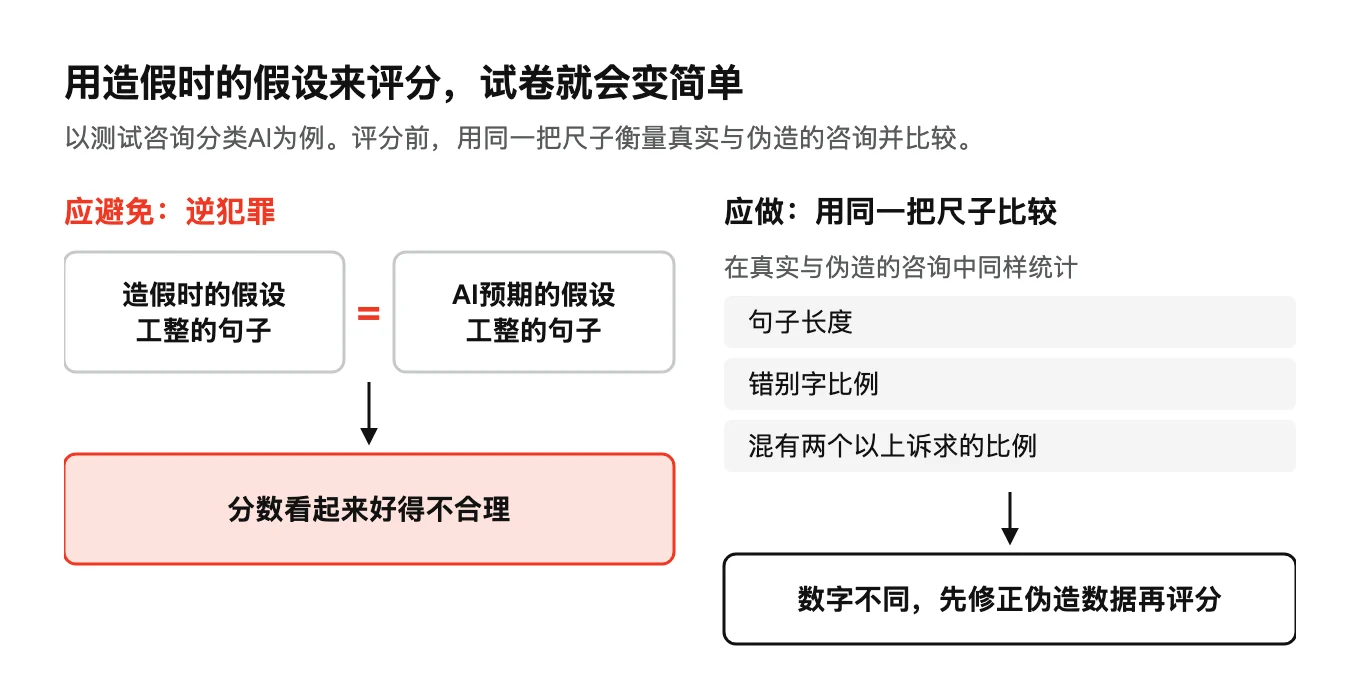
合成数据验证中最常见的陷阱就在这里。如果制作假数据时用的假设与AI预期的假设相同,AI就能轻松通过考试。
数学的反问题领域对此有专门的说法。合成数据时和求解这些数据时使用相同的理论材料,被称为逆犯罪(inverse crime),因为结果会显得好得不合理,所以被视为应当避免的做法。放到业务中就是:为了测试咨询分类AI而只用工整的句子来写假咨询,那么期待工整句子的AI就会拿到高分。真实咨询中夹杂的错别字、缩略语、一句话里提两个诉求的情况,试卷里都没有。
因此在使用假数据之前,必须用同一把尺子衡量真数据和假数据并加以比较。如果是咨询,就在真、假数据中用同样的方法统计句子长度、错别字比例、混有两个以上诉求的比例。如果是图像,就用同样的方式测量亮度分布、模糊程度、物体重叠的比例。数字不一致,就先修正假数据再评分。
也有方向相反的对策。机器人学习领域的域随机化(托宾等,2017)不是让假数据去贴合某一种真实情况,而是把纹理和光照大幅度地随机变化,让真实情况看起来只是众多变体之一。在这项研究中,仅用合成图像训练的物体定位模型在真实环境中达到了1.5 cm左右的精度。无论用哪种方法,问题都一样:这份试卷像真实问题吗?
二、逐个改变条件,找出误差原因
已知答案数据的真正价值,不在于一个分数,而在于它能告诉你是什么拉低了分数。现场数据的条件是一起变化的,无法区分原因;合成数据则可以一次只改变一个条件。
用静态图像测量粒径的国际标准ISO 13322-1就直接建议做这类实验。把相互接触的颗粒当成一个来测会产生误差,而仅靠图像分析往往难以发现,所以标准要求增减每个画面中的颗粒数,确认其影响。等于标准里写明了“改变条件,测量影响”。
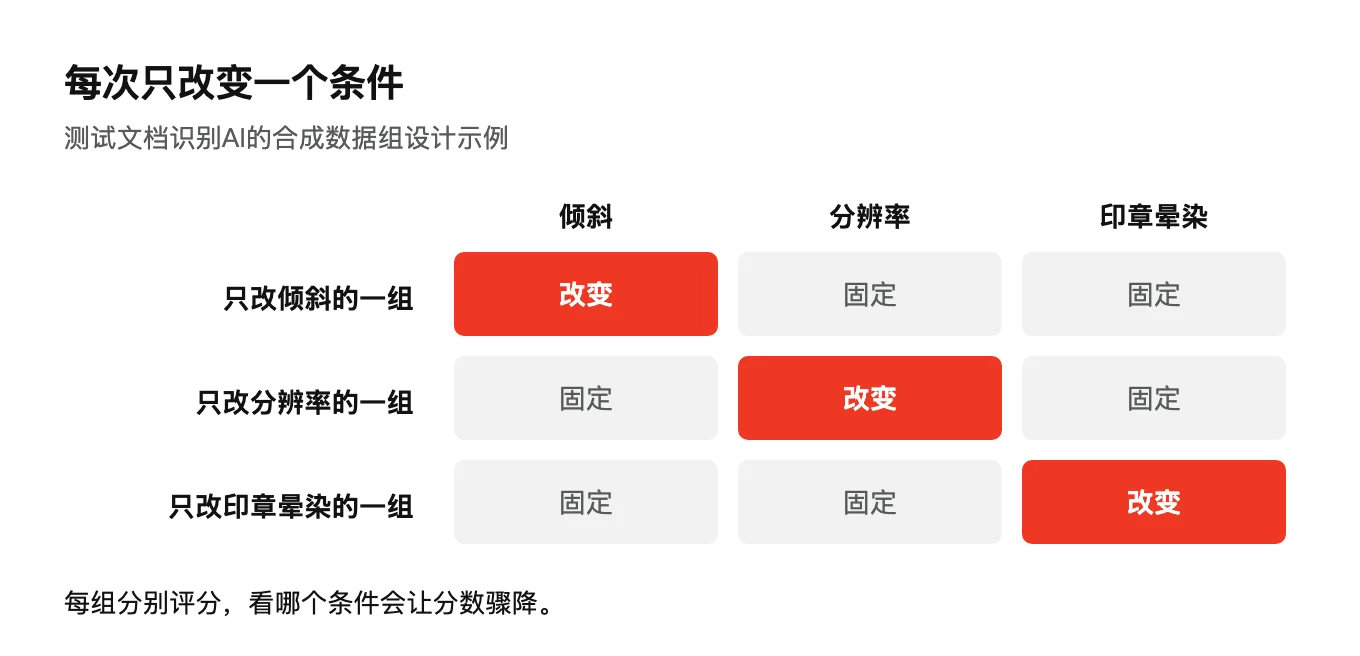
业务中同样适用。如果是文档识别,就分别制作只改变倾斜、只改变分辨率、只改变印章晕染的数据组,分别评分。看出在哪个条件下分数骤降,就能判断该改的是模型、拍摄方式还是输入格式。
衡量改进效果时也一样。每次修改提示词或调整规则,都用同一份试卷重新评分。凭目测挑参数,容易留下只在少数几个例子上看起来不错的设置。只有这样,才能知道改动是否真的带来了改善。
三、合成分数不是真实分数
合成数据验证不能替代实物验证。在假数据上误差15%,意思是“在像真数据的假数据上15%”,而不是在实际现场15%。报告中也要把两个数字分开写。
韩国处理合成数据的指引也强调同样的顺序。2024年12月,韩国个人信息保护委员会发布了合成数据生成与使用指南(韩语),提出了事前准备、生成、安全性与有用性验证、审议委员会评估、使用与管理五个阶段。这份指南的主要目的是保护个人信息,但它要求另行验证生成数据在多大程度上保留了原始数据的有用性,这一点同样适用于AI测试用的合成数据。
现实的顺序是:先用合成数据找出并修正失败类型和原因,再用少量已知答案的实物样本做最终确认。制作100个实物样本成本很高,但如果先用合成数据把问题筛掉,这100个样本就能用得更充分。
常见的三个错误
第一,做出太干净的假数据。没有错别字的咨询、拍得端端正正的单据、彼此分开摆放的零件,这类容易制作的假数据,对AI来说通常也很容易。那个分数只是上限。请从现场挑出几个最棘手的案例,把它们的特征故意放进假数据里。
第二,只看一个分数。平均准确率90%这个数字,不会告诉你漏掉了什么。可能没有漏检,却有很多把两条合成一条的情况;也可能有很多把不存在的东西找了出来。请把命中、漏检、错误合并、无中生有分开统计。
| 分开统计的项目 | 含义 |
|---|---|
| 命中 | 与答案表一致的结果 |
| 漏检 | 答案表中有却没找到的 |
| 错误合并 | 把两条合成了一条的 |
| 无中生有 | 答案表中没有却找出来的 |
第三,用同一份试卷既修改又评估。一边看试卷一边改规则,最后得到的就是只适合这份试卷的规则。尤其是以制作假数据时所用特征为标准进行筛选的规则,在这些假数据上自然看起来最好。请把修改时用的试卷和评估时用的试卷分开。
执行步骤
如果是第一次做,推荐按以下顺序进行:
- 确定答案。写清要答对什么,以及答案数据以什么格式保存
- 制作假数据。测量真实数据中的噪声、光照、错别字比例等条件并加以反映
- 衡量相似度。用同一把尺子衡量真假数据并比较统计量,不一致就修正假数据
- 评分。把命中、漏检、错误合并分开统计
- 改变条件。一次改一个,找出放大误差的条件
- 修正后重新评分。另留一份评估用试卷,比较改进前后
- 用实物确认。用少量已知答案的真实样本做最终检查,并记录合成分数与实物分数之间的差距
从试点转入正式运营时,这份试卷可以直接成为回归测试集。每次更换模型或提示词都跑同一份试卷,就能防止性能悄悄下滑。
运营期间试卷依然有用。就像葡萄酒评审中悄悄混入同一款酒那样,定期把几条已知答案的样本混进实际业务流程。比如每周把五张测试用报价单和其他单据一起放进去,确认结果。当输入格式变化或相机照明老化导致性能逐渐下降时,这些样本会最先发出提醒。人工复核也可以用同样的方法检查。运营成效用什么指标来看,在成效衡量篇中有更多讨论。
总结
先确认试卷像不像真实问题,逐个改变条件找出原因,最后用实物确认。同一个AI,在简单的试卷上可能是优等生,在难的试卷上却可能不及格。要相信分数,首先得能相信试卷。
关于这个主题的亲手实验记录,写在已知答案的假咖啡(韩语)一文中。
「先用已知答案的假数据来测试」系列
- 制作埋好答案的试卷
- 衡量假数据是否像真数据的方法(本文)