정답을 아는 가짜 데이터로 먼저 시험하십시오 — 가짜가 진짜를 닮았는지 재는 법 (2)
정답을 심은 합성 데이터로 AI를 시험해도, 가짜가 진짜를 닮지 않으면 점수가 부풀려집니다. 2편에서는 역범죄와 도메인 무작위화, ISO 화상 분석 표준, 개인정보보호위원회 합성데이터 안내서를 바탕으로 가짜와 진짜를 같은 잣대로 비교하는 법, 조건을 하나씩 흔들어 오차 원인을 찾는 법, 실물 검증으로 마무리하는 실행 순서를 정리했습니다.
시험지가 쉬우면 누구나 우등생이 됩니다. 합성 데이터의 점수를 믿으려면, 먼저 시험지가 진짜를 닮았는지 재십시오.
시험지를 믿을 수 있는가
1편에서는 정답을 아는 견본을 만들어 시험지로 쓰는 법을 다뤘습니다. 시험지가 생기면 바로 점수가 나옵니다. 그런데 이 점수가 높게 나왔다고 안심하기는 이릅니다. 가짜를 만든 사람과 AI를 만든 사람이 같은 가정을 하고 있었다면, 그 점수는 시험지가 쉬웠다는 뜻일 수 있습니다.
이번 편에서는 시험지 자체를 검사하는 세 가지 원칙과 처음 하는 팀이 자주 하는 실수, 그리고 실물 검증까지 이어지는 실행 순서를 다룹니다.
하나. 가짜가 진짜를 닮았는지 먼저 재십시오
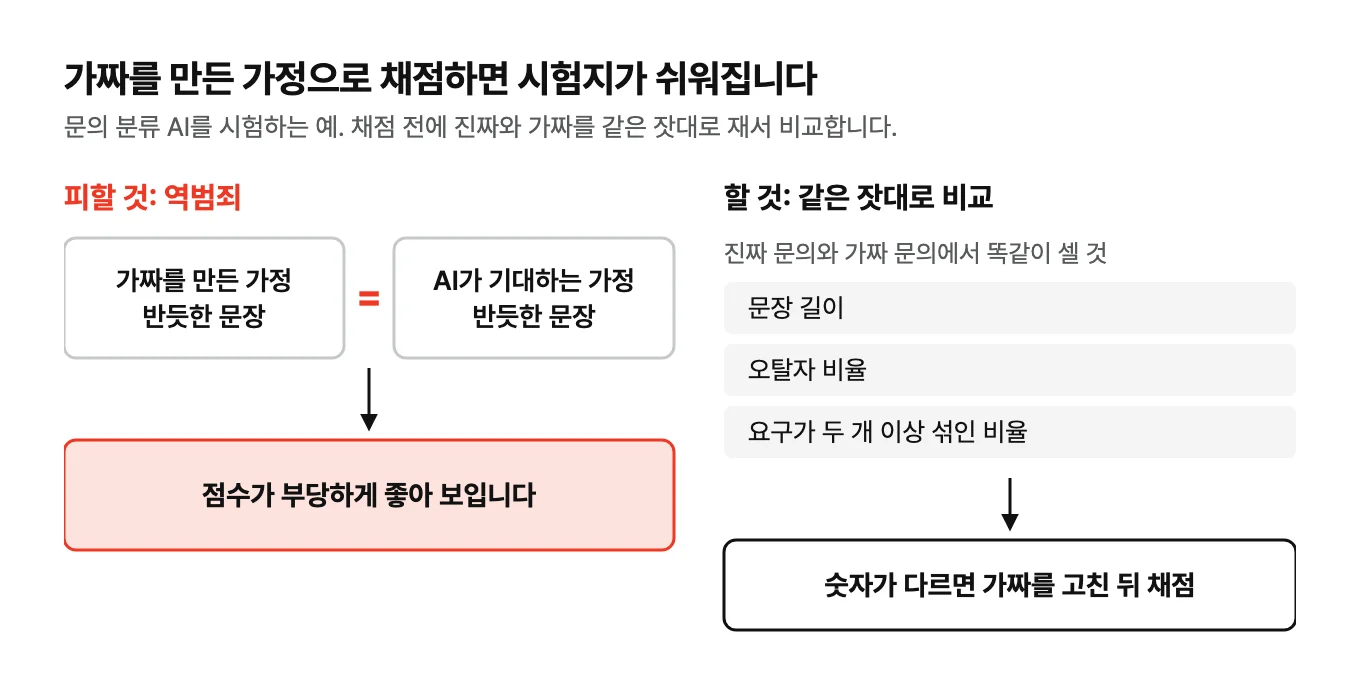
합성 데이터 검증에서 가장 흔한 함정이 여기 있습니다. 가짜를 만들 때 쓴 가정이 AI가 기대하는 가정과 같으면, AI는 시험을 쉽게 통과합니다.
수학의 역문제 분야에는 이를 가리키는 말이 따로 있습니다. 데이터를 합성할 때와 그 데이터를 풀 때 같은 이론 재료를 쓰는 것을 역범죄(inverse crime)라고 부르고, 결과가 부당하게 좋아 보이므로 피해야 한다고 가르칩니다. 업무로 옮기면 이렇습니다. 문의 분류 AI를 시험하려고 반듯한 문장으로만 가짜 문의를 쓰면, 반듯한 문장을 기대하는 AI는 높은 점수를 받습니다. 실제 문의에 섞인 오탈자, 줄임말, 요구 두 개가 한 문장에 든 경우는 시험지에 없습니다.
그래서 가짜를 쓰기 전에 진짜와 가짜를 같은 잣대로 재서 비교해야 합니다. 문의라면 문장 길이, 오탈자 비율, 요구가 두 개 이상 섞인 비율을 진짜와 가짜에서 똑같이 셉니다. 사진이라면 밝기 분포, 흐림 정도, 물체가 겹친 비율을 같은 방식으로 잽니다. 숫자가 다르면 가짜를 고친 뒤에 채점하십시오.
반대 방향의 처방도 있습니다. 로봇 학습 분야의 도메인 무작위화(토빈 등, 2017)는 가짜를 진짜 하나에 맞추는 대신 질감과 조명을 아주 넓게 흔들어, 진짜가 그 많은 변형 가운데 하나로 보이게 만듭니다. 이 연구에서는 합성 이미지로만 학습한 물체 위치 추정 모델이 실제 환경에서 1.5 cm 안팎의 정확도로 작동했습니다. 어느 방법을 쓰든 질문은 같습니다. 이 시험지가 실제 문제를 닮았습니까.
둘. 조건을 하나씩 흔들어 오차의 원인을 찾으십시오
정답을 아는 데이터의 진짜 가치는 점수 하나가 아니라 무엇이 점수를 깎는지를 알려 준다는 데 있습니다. 현장 데이터는 조건이 한꺼번에 바뀌어서 원인을 가를 수 없지만, 합성 데이터는 조건을 하나씩만 바꿀 수 있습니다.
정지 화상으로 입자 크기를 재는 국제 표준 ISO 13322-1이 이런 실험을 직접 권합니다. 맞닿은 입자를 하나로 재면 오차가 생기고 화상 분석만으로 그것을 찾아내기 어려운 경우가 많으니, 한 화면의 입자 수를 늘리고 줄여 가며 그 영향을 확인하라는 것입니다. 표준이 "조건을 바꿔 가며 영향을 재라"고 적어 둔 셈입니다.
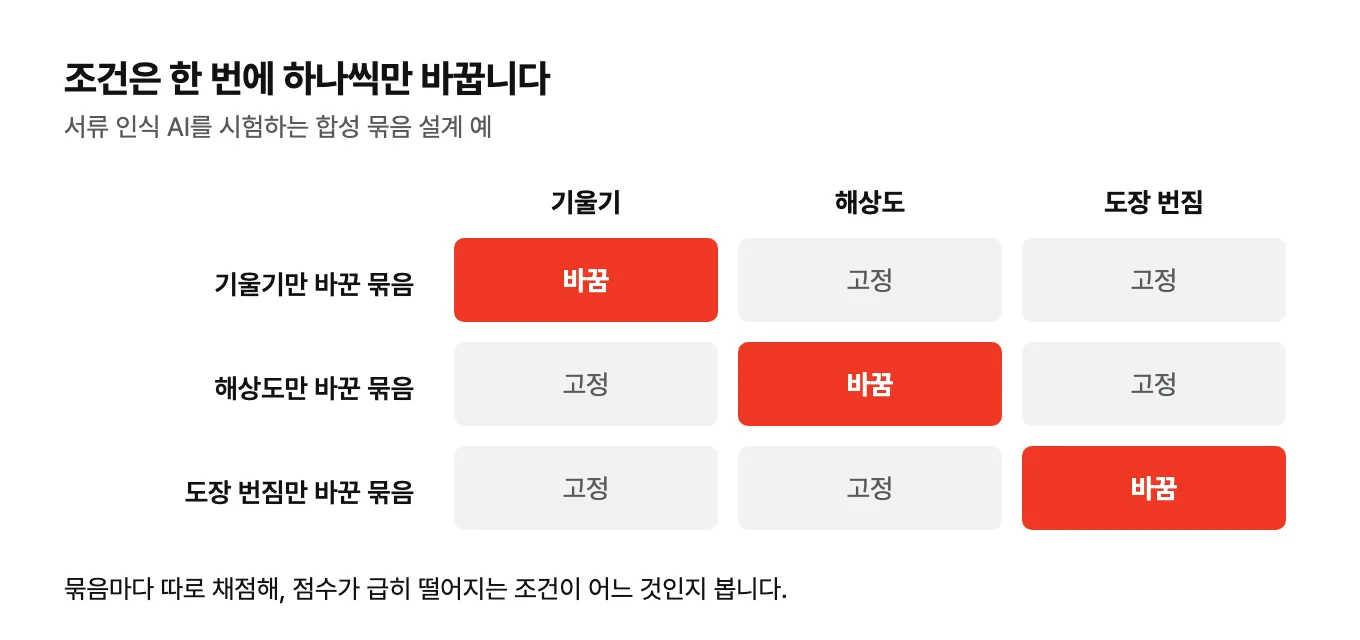
업무에서도 같은 방식이 통합니다. 서류 인식이라면 기울기만 바꾼 묶음, 해상도만 바꾼 묶음, 도장 번짐만 바꾼 묶음을 따로 만들어 채점합니다. 어느 조건에서 점수가 급히 떨어지는지 보이면, 고칠 곳이 모델인지 촬영 방법인지 입력 양식인지가 갈립니다.
개선의 효과를 잴 때도 같습니다. 프롬프트를 바꾸거나 규칙을 고칠 때마다 같은 시험지로 다시 채점하십시오. 값을 눈대중으로 고르면 몇 장의 예시에서만 좋아 보이는 설정이 남기 쉽습니다. 바꾼 것이 정말 나아졌는지는 그래야 압니다.
셋. 합성 점수는 진짜 점수가 아닙니다
합성 데이터 검증은 실물 검증을 대신하지 않습니다. 가짜에서 오차 15%라는 말은 "진짜를 닮은 가짜에서 15%"라는 뜻이지, 실제 현장에서 15%라는 뜻이 아닙니다. 보고서에도 두 숫자를 구분해 적어야 합니다.
합성 데이터를 다루는 국내 지침도 같은 순서를 강조합니다. 개인정보보호위원회는 2024년 12월 합성데이터 생성·활용 안내서를 내면서 사전준비, 생성, 안전성·유용성 검증, 심의위원회 평가, 활용과 관리의 다섯 단계를 제시했습니다. 개인정보 보호가 주목적인 안내서지만, 만든 데이터가 원본의 쓸모를 얼마나 유지하는지 별도로 검증하라는 요구는 AI 시험용 합성 데이터에도 그대로 적용됩니다.
현실적인 순서는 이렇습니다. 합성 데이터로 실패 유형과 원인을 먼저 찾고 고친 뒤, 정답을 아는 실물 견본 소수로 최종 확인합니다. 실물 견본 100개를 만드는 비용은 크지만, 합성 데이터로 문제를 먼저 걸러 두면 그 100개를 훨씬 알차게 쓸 수 있습니다.
자주 보는 실수 세 가지
하나, 너무 깨끗한 가짜를 만듭니다. 오탈자 없는 문의, 반듯하게 찍힌 서류, 떨어져 놓인 부품처럼 만들기 쉬운 가짜는 대개 AI에게도 쉽습니다. 그 점수는 상한선일 뿐입니다. 현장에서 가장 골치 아픈 사례 몇 개를 골라 그 특징을 가짜에 일부러 넣으십시오.
둘, 점수 하나만 봅니다. 평균 정확도 90%라는 숫자는 무엇을 놓쳤는지 알려 주지 않습니다. 놓친 것은 없는데 두 건을 한 건으로 합친 경우가 많을 수도 있고, 없는 것을 찾아낸 경우가 많을 수도 있습니다. 맞힌 것, 놓친 것, 잘못 합친 것, 없는데 찾은 것을 따로 세십시오.
| 따로 셀 것 | 뜻 |
|---|---|
| 맞힌 것 | 정답표와 일치한 결과 |
| 놓친 것 | 정답표에 있는데 찾지 못한 것 |
| 잘못 합친 것 | 두 건을 한 건으로 합쳐 버린 것 |
| 없는데 찾은 것 | 정답표에 없는데 찾아낸 것 |
셋, 같은 시험지로 고치고 평가합니다. 시험지를 보며 규칙을 고치다 보면 그 시험지에만 맞는 규칙이 됩니다. 특히 가짜를 만들 때 쓴 특징을 기준으로 거르는 규칙은 그 가짜에서 가장 좋아 보이기 마련입니다. 고칠 때 쓰는 시험지와 평가할 때 쓰는 시험지를 나눠 두십시오.
실행 순서
처음 해 보신다면 아래 순서를 권합니다.
- 정답을 정합니다. 무엇을 맞혀야 하는지, 정답 데이터를 어떤 형식으로 남길지 적습니다
- 가짜를 만듭니다. 실제 데이터에서 잡음, 조명, 오탈자 비율 같은 조건을 재서 반영합니다
- 닮았는지 잽니다. 진짜와 가짜를 같은 잣대로 재서 통계를 비교하고, 다르면 가짜를 고칩니다
- 채점합니다. 맞힌 것, 놓친 것, 잘못 합친 것을 따로 셉니다
- 조건을 흔듭니다. 한 번에 하나씩 바꿔 오차를 키우는 조건을 찾습니다
- 고치고 다시 채점합니다. 평가용 시험지는 따로 두고 개선 전후를 비교합니다
- 실물로 확인합니다. 정답을 아는 실제 견본 소수로 최종 점검하고, 합성 점수와 실물 점수의 차이를 기록합니다
파일럿에서 운영으로 넘어갈 때 이 시험지는 그대로 회귀 시험 묶음이 됩니다. 모델이나 프롬프트를 바꿀 때마다 같은 시험지를 돌리면, 성능이 몰래 떨어지는 일을 막을 수 있습니다.
운영 중에도 시험지는 쓸모가 있습니다. 와인 심사에서 같은 와인을 몰래 섞었듯, 정답을 아는 견본 몇 건을 실제 업무 흐름에 정기적으로 섞어 두십시오. 매주 시험용 견적서 다섯 장을 다른 서류와 함께 넣고 결과를 확인하는 식입니다. 입력 양식이 바뀌거나 카메라 조명이 노후해서 성능이 서서히 떨어질 때, 이 견본이 가장 먼저 알려 줍니다. 사람이 하는 검수도 같은 방식으로 점검할 수 있습니다. 운영 성과를 어떤 지표로 볼지는 성과 측정 편에서 더 다뤘습니다.
정리하면
시험지가 실제 문제를 닮았는지 먼저 확인하고, 조건을 하나씩 흔들어 원인을 찾고, 마지막에 실물로 확인하십시오. 같은 AI라도 쉬운 시험지에서는 우등생이고 어려운 시험지에서는 낙제생일 수 있습니다. 점수를 믿으려면 먼저 시험지를 믿을 수 있어야 합니다.
이 주제를 직접 실험해 본 기록은 정답을 아는 가짜 커피에 적어 두었습니다.
「정답을 아는 가짜 데이터로 먼저 시험하십시오」 연재
- 정답을 심은 시험지 만들기
- 가짜가 진짜를 닮았는지 재는 법 (현재 글)