정답을 아는 가짜 데이터로 먼저 시험하십시오 — 정답을 심은 시험지 만들기 (1)
AI나 자동 측정 시스템을 검증하려면 정답이 필요하지만, 현장 데이터에는 정답이 없는 경우가 많고 사람이 매긴 정답도 흔들립니다. 그럴 때는 정답을 미리 심어 둔 시험지를 먼저 만들 수 있습니다. 1편에서는 와인 심사, 미스터리 쇼핑, 돌연변이 시험, 합성 세포 사진 같은 국내외 사례로 정답을 심는 방법과 업무별 시험지 만드는 법을 정리했습니다.
정답이 없는 데이터로는 AI를 채점할 수 없습니다. 그럴 때는 정답을 심어 둔 시험지를 먼저 만드십시오.
채점할 정답이 없습니다
AI 도입 검증 단계에서 자주 막히는 지점이 있습니다. 결과를 맞춰 볼 정답이 없다는 것입니다.
불량 검출 AI라면 지난 사진에 "이건 불량"이라고 적힌 라벨이 있어야 하는데, 대부분 현장에는 합격·불합격 기록만 있고 어느 부위가 왜 불량인지는 남아 있지 않습니다. 서류 분류 AI라면 사람이 분류한 기록이 있지만, 그 사람의 판단이 맞았는지 아무도 모릅니다. AI 검증 설계 편에서 "답이 이미 나와 있는 사례를 고르라"고 말씀드렸는데, 그런 사례가 아예 없는 업무도 많습니다.
사람이 매긴 정답 자체가 흔들린다는 것도 문제입니다. 미국 캘리포니아 주립 박람회 와인 경연에서 로버트 호지슨(2008)은 심사위원 몰래 같은 병에서 따른 와인 세 잔을 30잔 사이에 섞어 넣었습니다. 해마다 65~70명을 시험했는데, 세 잔에 같은 메달 등급 안의 점수를 준 심사위원은 열에 한 명꼴이었습니다. 또 다른 열에 한 명은 같은 와인에 동메달부터 금메달까지 줬습니다. 전문가의 판정을 정답으로 쓰기 전에 그 정답이 얼마나 흔들리는지부터 알아야 한다는 뜻입니다.
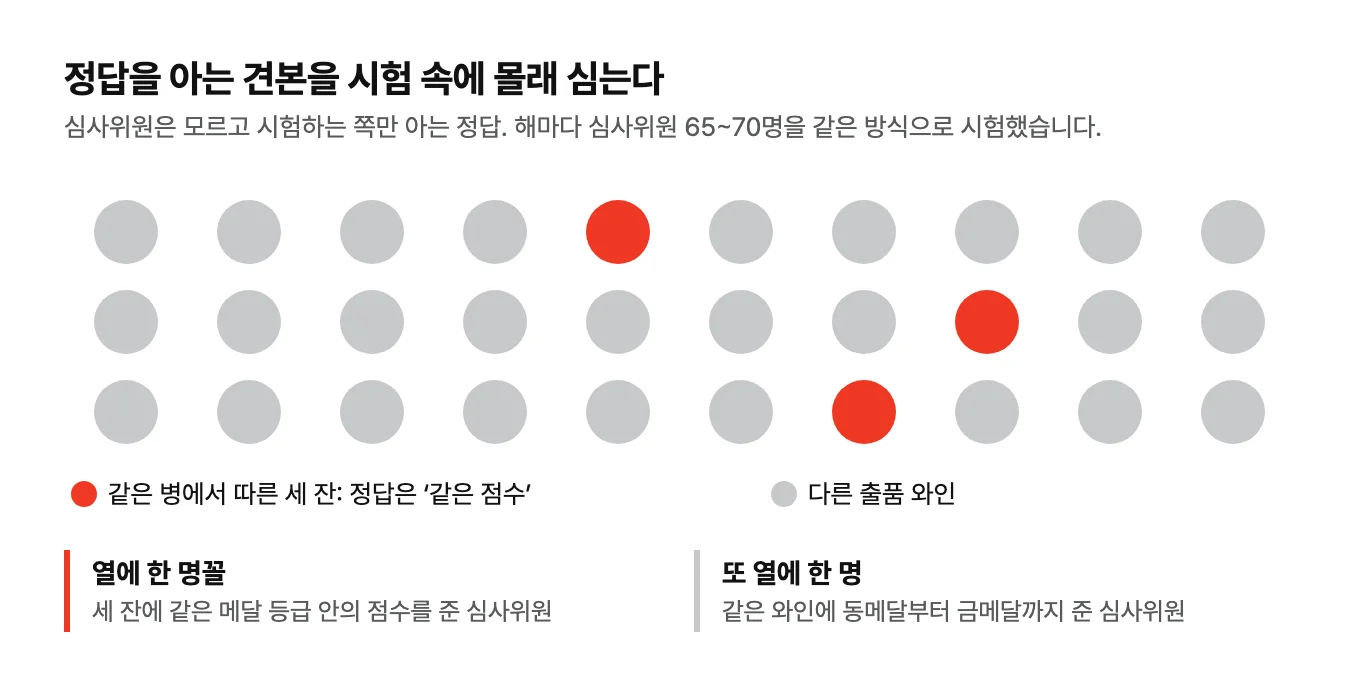
이 실험에서 눈여겨볼 것은 결과보다 방법입니다. 호지슨은 정답을 아는 견본을 시험 속에 몰래 심었습니다. 같은 와인이니 같은 점수가 나와야 한다는 정답을 그가 미리 알고 있었습니다. 이 연재는 이 방법을 AI 검증에 옮기는 이야기입니다. 1편에서는 정답을 심은 시험지를 만드는 법을, 2편에서는 그 시험지를 믿을 수 있게 만드는 법을 다룹니다.
정답을 심는 방법은 이미 널리 쓰입니다
정답을 아는 가짜를 섞어 시스템을 시험하는 방법은 새롭지 않습니다.
국내 금융권에는 미스터리 쇼핑이 있습니다. 금융감독원은 조사원을 고객처럼 꾸며 창구로 보내고, 판매 직원이 규정대로 설명하는지 점검합니다. 2018년 파생결합증권 판매 점검에서는 29개 금융사 440개 점포를 조사해 증권사 평균 83.9점, 은행 평균 64.0점이라는 결과를 냈습니다. 조사원이 어떤 고객인지 감독원이 알고 있으니, 그 고객에게 무엇을 설명해야 맞는지도 미리 정해져 있습니다. 정답을 아는 가짜 고객입니다.
소프트웨어 업계에는 돌연변이 시험이 있습니다. 코드에 일부러 작은 버그를 심고, 기존 테스트가 그 버그를 잡아내는지 봅니다. 잡지 못하면 테스트가 부족하다는 뜻입니다. 구글은 이 방법을 코드 리뷰에 붙여 2만 4천 명이 넘는 개발자, 1,000개가 넘는 프로젝트에서 운영한 결과를 2021년 논문으로 공개했습니다. 테스트를 시험하는 시험지를 만든 셈입니다.
생명과학에는 정답이 파일 이름에 적힌 사진 묶음이 있습니다. 미국 브로드 연구소의 BBBC005는 시뮬레이터로 그린 세포 사진 19,200장으로, 한 장에 세포가 1~100개 있고 초점 흐림을 단계별로 바꿔 가며 그렸습니다. 세포 수가 파일 이름에 들어 있어 세포를 세는 알고리즘을 바로 채점할 수 있습니다.
| 사례 | 시험받는 쪽 | 시험하는 쪽이 쥔 정답 |
|---|---|---|
| 와인 심사(호지슨, 2008) | 심사위원 | 같은 병의 세 잔은 같은 점수 |
| 미스터리 쇼핑(금융감독원, 2018) | 판매 직원 | 조사원이 어떤 고객이고 무엇을 설명받아야 하는지 |
| 돌연변이 시험(구글, 2021) | 기존 테스트 | 코드에 일부러 심은 작은 버그 |
| BBBC005(브로드 연구소) | 세포를 세는 알고리즘 | 파일 이름에 적힌 세포 수 |
네 사례의 공통점은 하나입니다. 시험하는 쪽이 정답을 쥐고 있고, 시험받는 쪽은 그것을 모릅니다.
정답을 아는 데이터를 먼저 만드십시오
검증의 첫 단계는 정답이 무엇인지 확실히 아는 데이터를 확보하는 것입니다. 현장 데이터에서 찾을 수 없다면 만들어야 합니다.
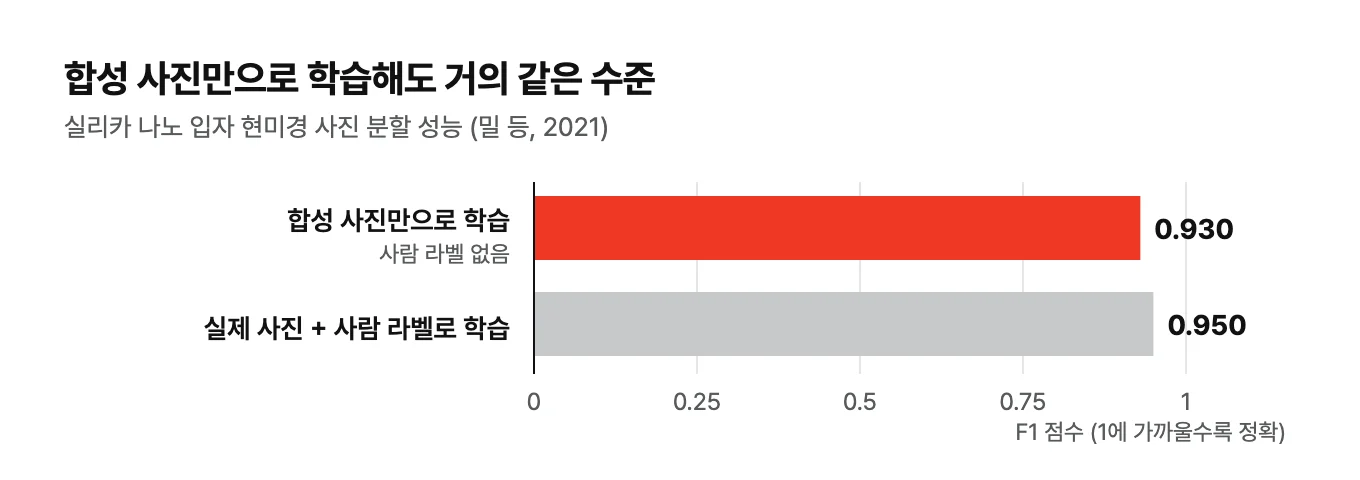
합성 데이터는 연구 현장에서 이미 실용 단계에 와 있습니다. 나노 입자 현미경 사진을 3차원 그래픽 프로그램으로 그려 학습시킨 밀 등(2021)의 연구에서, 합성 사진만으로 학습한 모델은 실리카 입자 분할에서 F1 0.930을 기록했습니다. 실제 사진에 사람이 라벨을 붙여 학습한 모델은 0.950이었습니다. 사람이 한 장씩 윤곽을 그리는 수고 없이 거의 같은 수준에 도달한 것입니다. 앤드루 응도 IEEE 스펙트럼 인터뷰에서 특정 불량 유형에서 성능이 낮을 때 합성 데이터를 만들면 그 문제를 더 겨냥해서 다룰 수 있다고 말했습니다.
중소기업 업무로 옮기면 거창할 필요가 없습니다. 크기를 아는 견본 부품, 일부러 오류를 넣은 견적서, 정답 분류를 정해 둔 가상 민원 몇십 건이면 시작할 수 있습니다. 핵심은 데이터의 양이 아니라 정답을 내가 쥐고 있다는 점입니다.
시험지를 만들기 쉬운 업무
업무별로 정답을 심는 방법은 이렇게 달라집니다.
- 문서 인식(OCR)·서류 입력: 금액, 날짜, 거래처를 미리 정해 둔 가상의 견적서와 영수증을 만들어 인쇄하고, 스캔하거나 휴대폰으로 찍어 넣습니다. 구김, 기울기, 흐린 도장도 일부러 섞습니다
- 고객 문의 분류: 지난 문의를 참고해 분류가 확실한 가상 문의를 쓰되, 오탈자와 줄임말, 두 가지 요구가 섞인 문장을 실제 비율만큼 넣습니다
- 불량 검출: 크기와 위치를 아는 결함을 견본 부품에 일부러 만들거나, 정상 제품 사진에 결함 모양을 합성합니다
- 이상 거래·부정 탐지: 정상 거래 기록 사이에 규칙 위반 사례를 몇 건 심어 두고, 몇 건을 찾아내는지 셉니다
어느 경우든 정답표를 시험지와 따로 보관해야 합니다. 정답이 AI 입력에 섞여 들어가면 시험이 아니라 받아쓰기가 됩니다.
정답표에 적을 것
정답표는 맞았다, 틀렸다만 적는 표가 아닙니다. 나중에 무엇이 점수를 깎았는지 찾으려면 견본마다 조건도 함께 적어 두어야 합니다. 서류라면 기울기와 구김 정도, 문의라면 오탈자 수와 요구가 몇 가지 섞였는지, 부품이라면 결함 크기와 조명 각도입니다. 이 조건 칸이 있어야 2편에서 다룰 "조건을 하나씩 흔들어 원인을 찾는" 작업을 할 수 있습니다.
정리하면
현장 데이터에 정답이 없다고 검증을 포기할 필요는 없습니다. 정답을 아는 견본을 만들고, 정답표를 시험지와 따로 두고, 견본마다 조건을 적어 두십시오. 와인 심사와 미스터리 쇼핑이 보여 주듯, 정답을 쥔 쪽이 시험을 설계하면 정답 없는 현장에서도 채점할 수 있습니다. 시험지를 만드는 데 드는 비용은 대개 실패한 파일럿 한 번보다 작습니다. 기존 데이터에 정답 기록이 얼마나 남아 있는지부터 보고 싶으시다면 데이터 상태 점검 편을 함께 참고하십시오.
다음 편에서는 그 시험지가 실제 문제를 닮았는지 확인하는 법과, 합성 점수를 실물 검증으로 이어 가는 순서를 다룹니다.
「정답을 아는 가짜 데이터로 먼저 시험하십시오」 연재
- 정답을 심은 시험지 만들기 (현재 글)
- 가짜가 진짜를 닮았는지 재는 법
참고 자료
- Hodgson RT, An Examination of Judge Reliability at a major U.S. Wine Competition, Journal of Wine Economics (2008)
- 비즈니스워치, 금감원 파생결합증권 미스터리쇼핑 결과 (2018)
- Petrović G 외, Practical Mutation Testing at Scale: A view from Google (2021)
- Broad Institute, BBBC005 합성 세포 사진 묶음
- Mill L 외, Synthetic Image Rendering Solves Annotation Problem in Deep Learning Nanoparticle Segmentation (2021)
- IEEE Spectrum, Andrew Ng: Unbiggen AI (2022)