콘텐츠 제작을 AI에 나눠 맡길 때 — 공정을 쪼개고 검수 지점을 정하는 법 (1)
대본, 목소리, 자료 화면, 자막까지 AI가 나눠 맡으면 영상 한 편은 혼자서도 나옵니다. 남는 일은 검수입니다. 방송사의 AI 앵커 운영 방식, 저품질 AI 영상의 확산과 유튜브의 수익화 정책, CNET의 AI 기사 오류 사례, AP통신의 생성형 AI 기준을 바탕으로 콘텐츠 제작 공정을 어떻게 나누고 공정 사이 어디에 사람의 확인을 둘지 정리했습니다.
영상을 만드는 일은 이제 누구나 할 수 있습니다. 차이는 무엇을 걸러내느냐에서 납니다.
영상 한 편, 이제 혼자서도 나옵니다
마케팅 담당자 한 명이 회사 블로그 글을 유튜브 해설 영상으로 옮기려 한다고 해 보겠습니다. 예전이라면 대본을 쓰고, 녹음하고, 화면에 깔 자료를 찾고, 자르고, 자막을 다는 일을 모두 사람이 해야 했습니다. 외주를 맡기면 비용이 들었고, 직접 하면 며칠이 걸렸습니다.
지금은 이 공정 대부분을 AI가 나눠 맡습니다. 글을 읽고 대본을 쓰는 일은 언어 모델이, 낭독은 음성 합성(TTS)이, 화면 고르기는 이미지 모델이, 자막은 받아쓰기 모델이 합니다. 국내 도구만 봐도 보이저엑스의 브루(Vrew)는 대본, 이미지, 음성을 한 번에 만들어 주는 '텍스트로 비디오 만들기' 기능을 제공합니다.
방송사는 이 흐름을 일찍 시작했습니다. MBN은 2020년 '김주하 AI 앵커'를 도입했는데, 실제 앵커의 모습과 목소리를 10시간 녹화해 학습시켰고 최대 1,000자의 텍스트를 1분 안에 영상으로 합성할 수 있다고 소개했습니다. 눈여겨볼 대목은 그다음입니다. 기자가 기사 스크립트를 쓰고, 담당 PD가 자막과 영상 편집을 거친 뒤에야 업로드한다고 밝혔습니다. AI가 화면에 서도 원고와 편집의 책임은 사람에게 남겨 둔 구조입니다.
중소기업이 콘텐츠 운영을 자동화할 때 가져와야 할 것도 이 구조입니다. 무엇을 AI에 맡기느냐보다 어디에서 사람이 확인하느냐를 먼저 정해야 합니다.
쉬워진 만큼 흔해졌습니다
만들기 쉬워지면 생기는 일이 있습니다. 영상 편집 서비스 Kapwing이 2025년 11월 낸 AI 슬롭 보고서에 따르면 새로 만든 계정의 유튜브 쇼츠 피드에 처음 뜬 영상 500개 중 104개(21%)가 저품질 AI 생성 영상이었습니다. 같은 보고서에서 이런 채널의 조회수가 가장 많은 나라는 한국이었습니다.
플랫폼도 선을 긋기 시작했습니다. 유튜브는 2025년 7월 수익화 정책의 '반복적 콘텐츠' 항목 이름을 비진정성(inauthentic) 콘텐츠로 바꾸며 거의 같은 틀로 대량 생산한 영상이 수익 창출 대상이 아니라는 점을 분명히 했습니다. AI를 썼다는 사실 자체를 막는 것은 아닙니다. 문제 삼는 것은 사람의 해설과 구성이 빠진 양산입니다.
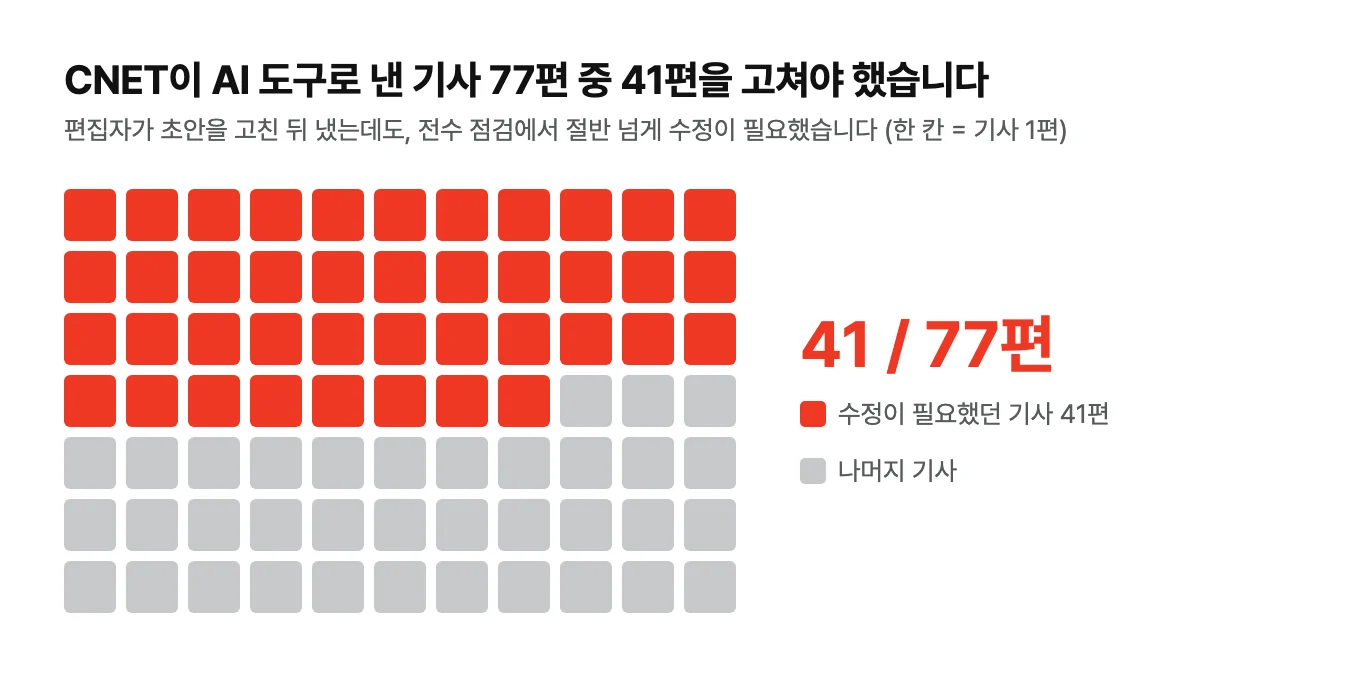
품질 사고도 이미 있었습니다. 미국 IT 매체 CNET은 2022년 말부터 AI 도구로 금융 기초 해설 기사 77편을 냈는데, 외부에서 오류가 지적된 뒤 전수 점검해 보니 41편에서 수정이 필요했습니다. 회사명 일부가 빠지거나 숫자가 뒤바뀐 경우가 많았고, 원문과 지나치게 비슷한 문장을 고친 사례도 있었습니다. 편집자가 초안을 고친 뒤 냈는데도 그랬습니다.
회사 채널은 개인 채널보다 이런 사고의 비용이 큽니다. 잘못된 숫자 하나, 권리가 불분명한 사진 한 장이 브랜드 신뢰를 깎습니다. 그래서 공정을 나누는 방법과 검수를 두는 자리를 먼저 정해야 합니다.
원칙 하나. 공정을 쪼개고, 공정마다 결과물을 남기십시오
"글을 영상으로 만들어 줘"라고 한 번에 맡기면 무엇이 어디서 틀렸는지 알 수 없습니다. 공정을 나누고 공정마다 사람이 열어 볼 수 있는 중간 결과물을 남기십시오.
| 공정 | 맡는 AI | 남길 중간 결과물 |
|---|---|---|
| 대본 | 언어 모델 | 줄 단위 텍스트 파일. 줄마다 근거가 된 원문 문장을 옆에 붙입니다 |
| 음성 | 음성 합성(TTS) | 줄 단위 오디오와 받아쓰기 결과. 숫자와 외래어를 어떻게 읽었는지 확인할 수 있습니다 |
| 화면 자료 | 이미지 모델 | 컷마다 파일, 원본 주소, 이용허락 조건을 적은 목록 |
| 자막·합성 | 받아쓰기 모델 | 최종 영상과 컷 목록(몇 초에 어떤 자료가 나오는지) |
이렇게 나눠 두면 문제가 생겼을 때 그 공정만 다시 돌릴 수 있습니다. 음성의 숫자 읽기가 틀렸다면 대본과 화면은 그대로 두고 음성만 고치면 됩니다.
미국 AP통신이 2023년 8월 내놓은 생성형 AI 기준은 생성형 AI 도구의 결과물을 모두 "검증되지 않은 소재(unvetted source material)"로 다루라고 정했습니다. 기자가 취재원에게서 들은 말을 그대로 기사에 쓰지 않듯, AI가 만든 대본도 확인 전에는 재료일 뿐이라는 뜻입니다. 중간 결과물을 남기는 습관이 있어야 이 원칙을 실제로 지킬 수 있습니다.
원칙 둘. 검수는 끝에 한 번이 아니라 공정 사이에 두십시오
완성된 영상을 처음부터 끝까지 한 번 보고 "괜찮네" 하는 검수는 거의 아무것도 잡지 못합니다. 영상은 흘러가고, 사람의 눈은 그럴듯한 화면을 맞는 화면으로 받아들입니다. CNET의 기사도 편집자가 읽고 냈습니다.
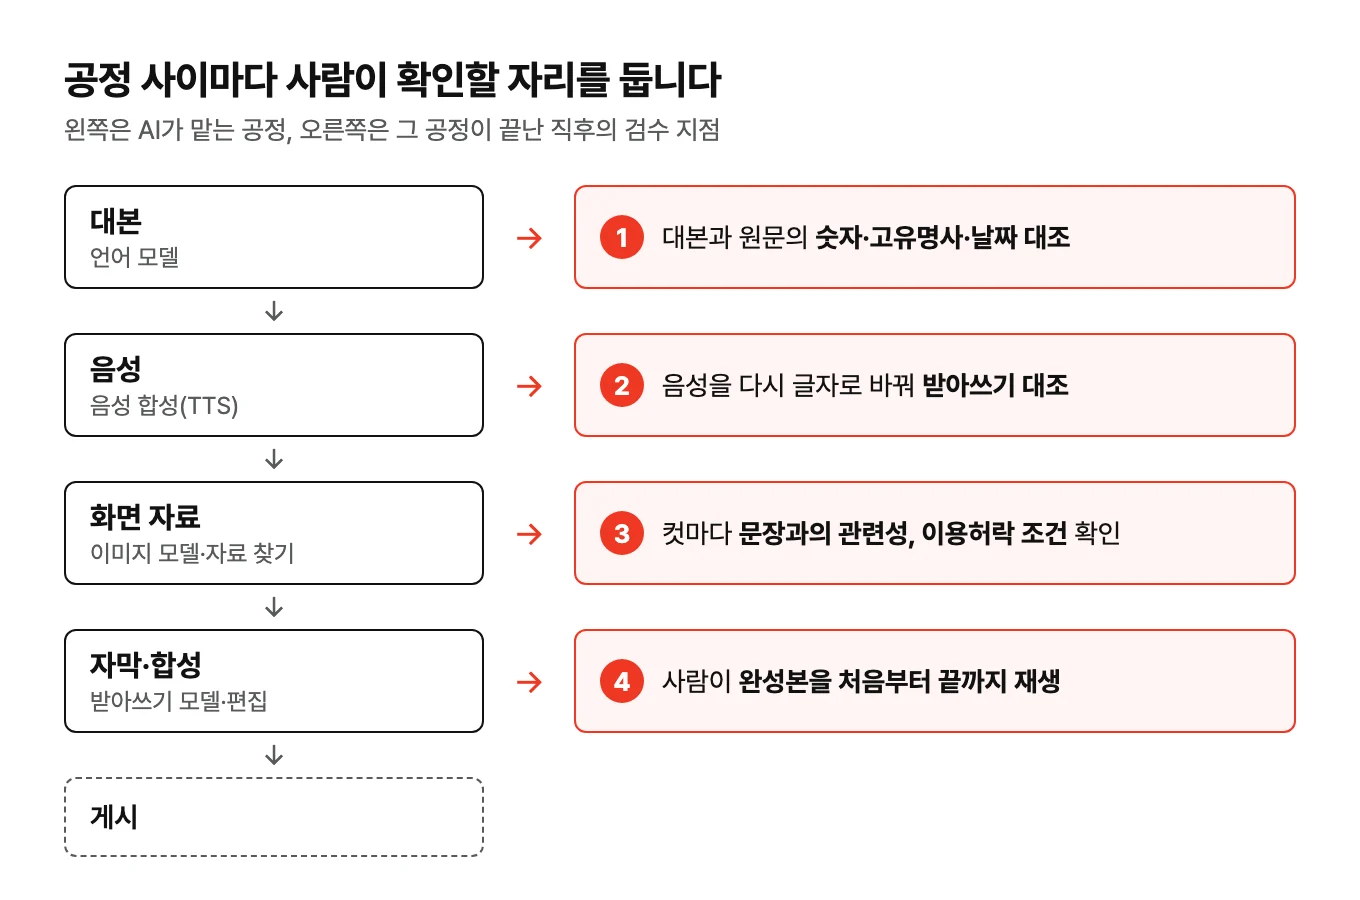
검수 지점은 틀리면 뒤 공정 전체가 틀어지는 자리에 둡니다. 실무에서 효과가 큰 자리는 넷입니다.
- 대본과 원문의 숫자 대조: 대본에 나온 수치, 고유명사, 날짜가 원문에 그대로 있는지 확인합니다. 원문에 없는 숫자가 나오면 무조건 멈춥니다. 이 대조는 사람이 하기보다 스크립트로 기계적으로 하는 편이 정확합니다.
- 음성의 받아쓰기 대조: TTS 결과를 받아쓰기 모델로 다시 글자로 바꿔 대본과 비교합니다. "6억"을 "육 억"으로 읽었는지, 영문 제품명을 엉뚱하게 읽었는지가 여기서 잡힙니다.
- 화면 자료의 관련성과 권리: 컷마다 문장과 관련이 있는지, 워터마크나 광고가 섞이지 않았는지, 이용허락 조건이 확인됐는지 봅니다. 지도가 들어간 화면은 지명 표기도 확인 대상입니다.
- 완성본 재생: 마지막에 사람이 처음부터 끝까지 한 번 재생합니다. 다만 이것은 앞의 셋을 대신하지 못합니다.
AI가 쓴 결과물을 어떻게 검증하는지는 AI가 만든 것을 어떻게 검증하십니까에서, AI가 자신 있게 틀리는 문제는 환각을 다루는 법에서 자세히 다뤘습니다. 콘텐츠 공정에서는 이 검증을 공정 사이사이에 잘게 나눠 넣는 것이 핵심입니다.
첫 달에 할 일
처음부터 전 공정을 자동화하려 하지 마십시오.
- 공정표 한 장 그리기: 대본, 음성, 자료, 자막, 합성, 게시를 칸으로 나누고 칸마다 AI 담당과 사람 담당을 적습니다.
- 검수 지점 네 곳 정하기: 숫자 대조, 받아쓰기 대조, 화면 확인, 완성본 재생. 담당자 이름을 붙입니다.
- 세 편 시험 후 확장: 처음 세 편은 공정마다 사람이 전부 열어 보고, 자주 걸리는 항목을 자동 점검으로 옮긴 뒤에 편수를 늘립니다.
정리하면
대본, 목소리, 자료 찾기는 AI에 나눠 맡길 수 있습니다. 맡길 수 없는 것은 원문에 없는 말을 지어내지 않았는지에 대한 판단입니다. 이 판단을 끝에 한 번 몰아서 하지 말고 공정 사이에 나눠 두십시오.
다음 편에서는 화면 자료의 사용 권리, 목소리와 저작권, 그리고 AI 기본법과 유튜브가 요구하는 AI 표시를 다룹니다.
「콘텐츠 제작을 AI에 나눠 맡길 때」 연재
- 공정을 쪼개고 검수 지점을 정하는 법 (현재 글)
- 출처·권리·AI 표시를 따로 따지는 법